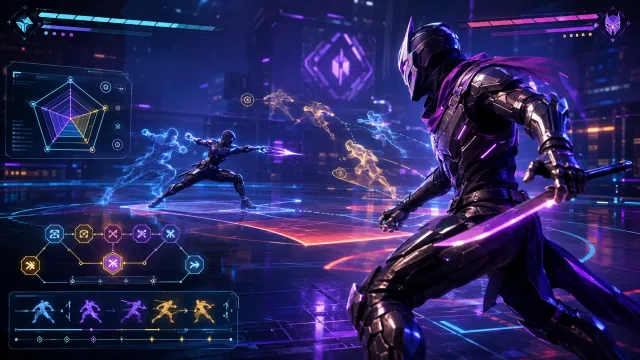
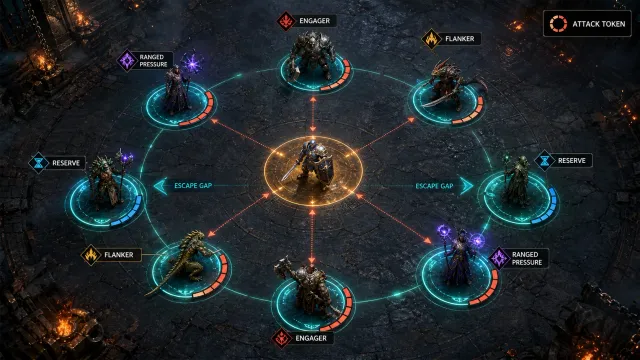
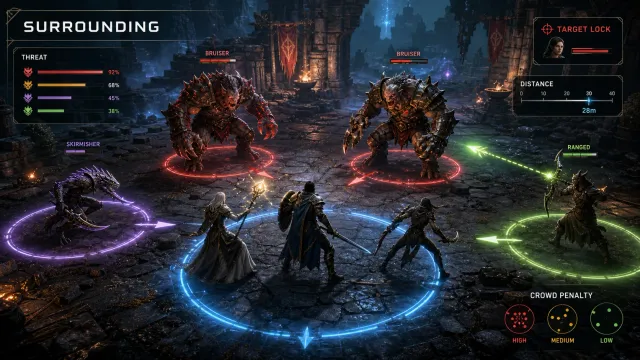
AI 기반 인게임 라이벌·보스의 플레이어 스타일 복제 시스템 기획
플레이어 행동 로그를 전투 특징 벡터로 변환해 AI 라이벌과 보스에 반영하는 시스템을 설계한다. 공정성, 난이도 밸런싱, 데이터 보호, 텔레그래프 UX까지 구현 기준과 수식을 정리한다.
핵심 요약
AI 기반 라이벌·보스의 플레이어 스타일 복제는 플레이 기록을 그대로 재생하는 기능이 아니라 행동 로그를 전투 특징 벡터(feature vector) 로 압축한 뒤 제한된 스킬 규칙 안에서 재조합하는 게임 시스템이다. 핵심은 닮은 전투 감각을 만들되 플레이어의 입력 권한과 보상 공정성을 침해하지 않도록 복제 강도·예측 가능성·난이도 상한을 함께 설계하는 데 있다.
플레이어 스타일 복제 시스템은 무엇을 해결하는가?
일반적인 보스는 정해진 패턴을 학습하는 재미를 제공한다. 반면 라이벌형 AI는 플레이어가 자주 쓰는 거리, 회피 방향, 공격 연결, 자원 소비 성향을 반영해 ‘나와 비슷하지만 더 정교한 상대’라는 인상을 만들 수 있다.
그러나 원본 입력을 그대로 복제하면 문제가 생긴다. 반응 속도가 인간보다 빠른 AI, 플레이어에게만 있는 장비 조합, 특정 상황에서만 성립하는 콤보까지 그대로 가져오면 불공정한 보스가 된다. 따라서 목표는 완전한 복제가 아니라 스타일의 인식 가능한 일부를 제약된 규칙으로 재현하는 것이다.
| 구분 | 단순 로그 재생 | 스타일 복제 라이벌 |
|---|---|---|
| 데이터 단위 | 시간순 입력·행동 | 거리, 빈도, 성공률, 전환 규칙 |
| 장점 | 구현이 단순함 | 상황 적응과 개성 표현이 가능함 |
| 위험 | 맥락이 달라 쉽게 붕괴 | 과도한 대응 시 불공정해질 수 있음 |
| 권장 용도 | 고스트, 리플레이 | 라이벌, 네메시스, 최종 보스 |
플레이어 스타일을 어떻게 데이터로 변환할까?
1. 전투 이벤트를 표준화한다
엔진과 무관하게 전투 로그는 이벤트 단위로 수집한다. Unity 6의 C#이라면 CombatEvent를 만들고 Unreal Engine 5라면 Gameplay Ability System의 어빌리티 발동과 피격 이벤트에 같은 필드를 연결할 수 있다.
public sealed class CombatEvent
{
    public float Time { get; }
    public CombatAction Action { get; }
    public float DistanceToTarget { get; }
    public float HealthRatio { get; }
    public float StaminaRatio { get; }
    public bool HitConfirmed { get; }
    public bool WasPunished { get; }

    public CombatEvent(
        float time,
        CombatAction action,
        float distanceToTarget,
        float healthRatio,
        float staminaRatio,
        bool hitConfirmed,
        bool wasPunished)
    {
        Time = time;
        Action = action;
        DistanceToTarget = distanceToTarget;
        HealthRatio = healthRatio;
        StaminaRatio = staminaRatio;
        HitConfirmed = hitConfirmed;
        WasPunished = wasPunished;
    }
}
이 모델은 Unity C#의 record/init 호환성 차이를 피하려고 일반 클래스로 작성했습니다. Unity 6은 C# 9를 사용하며, record의 init 지원에는 IsExternalInit 타입이 필요한 제한이 있습니다.
최소 수집 항목은 다음 정도면 충분하다.
- 공격 유형별 사용 비율: 약공격, 강공격, 원거리, 방어, 회피
- 교전 거리 분포: 근접, 중거리, 원거리 체류 시간
- 자원 임계값: 체력·스태미나·탄약이 낮을 때의 행동 변화
- 연계 규칙: 특정 행동 뒤에 이어지는 다음 행동의 조건부 확률
- 위험 성향: 피격 직후 반격, 후퇴, 회복을 선택하는 비율
2. 로그를 특징 벡터로 압축한다
예를 들어 플레이어 스타일 벡터를 아래처럼 정의할 수 있다.
각 항목은 약공격 비중, 강공격 비중, 원거리 공격 비중, 방어 비중, 회피 비중, 회복 시도 비중, 평균 교전 거리, 콤보 지속 길이다. 모든 비율 항목은 최근 전투 3~5회에 지수이동평균(EMA)을 적용하면 일회성 실수에 덜 흔들린다.
보통 (\alpha)는 0.2~0.4 범위에서 시작해 테스트한다. 단, 긴 전투와 짧은 전투의 표본 수가 달라지므로 전투 단위 평균과 이벤트 단위 평균을 혼동하지 않아야 한다.
3. 복제율을 상황별로 제한한다
라이벌의 최종 행동 정책을 플레이어 성향만으로 만들지 않는다. 기본 보스 정책 B, 플레이어 스타일 P, 밸런싱 제약 C를 혼합한다.
여기서 m은 복제율이다. 초반 라이벌은 0.2~0.4, 중후반 네메시스는 0.5~0.7처럼 설계할 수 있다. 1.0은 거의 권장하지 않는다. 보스 고유 패턴과 역할이 사라지고 플레이어가 자신의 약점을 거울처럼 맞는 경험만 남기기 쉽다.
라이벌 보스의 공정성은 왜 쉽게 무너지는가?
스타일 복제 AI는 플레이어의 선택을 알고 있다는 인상을 주기 때문에 실제 난이도보다 더 불공정하게 느껴질 수 있다. 특히 다음 세 가지를 금지 규칙으로 두는 편이 안전하다.
| 금지 규칙 | 문제 | 대안 |
|---|---|---|
| 입력 직후 즉시 카운터 | 반응 지연이 0ms인 것처럼 보임 | 250~500ms 의사결정 지연 적용 |
| 회복 행동마다 확정 처벌 | 플레이어 회복권을 제거함 | 거리·시야·쿨다운 조건이 맞을 때만 압박 |
| 장비·빌드 완전 복제 | 플레이어의 성장 보상이 희석됨 | 전용 스킬셋에서 역할만 모사 |
| 숨은 상태값 기반 대응 | 학습할 단서가 없음 | 모션, 음성, 이펙트로 의도를 예고 |
공정성은 AI가 약해서 생기는 것이 아니라 플레이어가 결과를 이해하고 다음 시도에서 대응할 수 있을 때 생긴다. 따라서 라이벌이 플레이어의 회피 습관을 노린다면 공격 전 자세 변화나 특정 대사를 통해 ‘회피를 읽고 있다’는 텔레그래프를 제공해야 한다.
flowchart LR
    L[전투 로그] --> F[특징 추출]
    F --> M[복제율 혼합]
    M --> G[공정성 가드레일]
    G --> T[텔레그래프 가능한 행동]
    T --> R[전투 결과]
    R --> L
플레이어 스타일 복제 보스를 단계별로 설계하는 방법
1. 복제할 스타일 신호를 3개만 고른다
첫 버전에서 모든 행동을 학습하려 하지 않는다. 예를 들어 액션 게임이라면 다음 세 신호가 가성비가 좋다.
- 주 교전 거리
- 회피 후 공격 전환 비율
- 고위험 공격 사용 비율
이 세 신호만으로도 ‘거리를 유지하며 찌르는 라이벌’, ‘회피 후 반격을 노리는 라이벌’, ‘강공격으로 압박하는 라이벌’을 명확히 구분할 수 있다.
2. 스타일별 행동 예산을 만든다
행동마다 피해량이 아니라 행동 예산을 부여한다. 예를 들어 플레이어가 강공격을 많이 쓴다고 해서 라이벌의 강공격 빈도를 무제한으로 올리지 않는다. 강공격 사용 확률은 높이되 연속 사용 횟수, 가드 불가 횟수, 추격 거리에는 상한을 둔다.
HeavyAttackWeight = lerp(0.15, 0.45, playerHeavyAttackRatio)
MaxHeavyAttackChain = 2
HeavyAttackCooldown = 4.0 seconds
UnblockableBudgetPerPhase = 1
이 방식은 스타일은 전달하면서도 보스의 파훼 가능성을 유지한다. 특히 페이즈 전환 시 예산을 초기화할지 유지할지는 난이도 체감에 큰 영향을 준다. 첫 구현에서는 페이즈별로 별도 예산을 두는 편이 디버깅에 유리하다.
3. 실패한 복제를 다음 전투에 반영한다
복제 결과의 성공 지표는 보스 승률 하나가 아니다. 다음 지표를 함께 본다.
- 첫 조우 이탈률과 재도전율
- 플레이어가 라이벌의 변화를 인지했다는 설문 또는 전투 후 선택지 반응
- 행동별 사망 기여도와 회피 가능 시간
- 복제 신호별 발동률 및 플레이어 빌드별 편차
한 행동이 사망 원인의 50% 이상을 차지하고 대응 시간이 짧다면 그 행동의 가중치보다 텔레그래프 길이와 재사용 대기시간을 먼저 조정한다.
UX와 내러티브로 복제 사실을 어떻게 전달할까?
플레이어가 AI의 적응을 알아차리지 못하면 복제 시스템에 투자한 비용이 드러나지 않는다. 반대로 내부 수치까지 공개하면 공략이 기계적으로 변한다. 추천하는 전달 방식은 세 단계다.
- 사전 암시: 라이벌이 플레이어의 무기나 전투 자세를 관찰하는 연출을 넣는다.
- 전투 중 확인: 플레이어의 대표 행동을 닮은 한두 개 기술을 명확한 모션과 대사로 보여 준다.
- 전투 후 해석: 결과 화면에 ‘회피 후 반격을 분석함’처럼 정성적 피드백을 제공한다.
‘당신의 모든 행동을 학습했다’보다 ‘당신의 회피 타이밍을 읽었다’가 더 정확하고 공정한 표현이다. 실제 구현 범위와 서술의 약속도 일치해야 한다.
자주 묻는 질문 (FAQ)
Q. 실제 플레이어 입력을 리플레이하는 방식이 더 자연스럽지 않은가?
A. 고스트 콘텐츠에는 적합하지만 보스 전투에는 취약하다. 지형, 거리, 장비, 현재 체력이 달라지면 원본 행동의 맥락이 사라진다. 특징 벡터와 상태 기반 행동 트리를 결합하는 방식이 더 안정적이다.
Q. 플레이어 데이터가 적으면 어떻게 처리해야 하는가?
A. 기본 보스 정책을 우선 적용하고 신뢰도 임계값을 넘은 신호만 반영한다. 예를 들어 강공격을 20회 이상 사용했을 때만 강공격 성향을 반영하도록 설계할 수 있다.
Q. 싱글플레이에서도 개인정보 고지가 필요한가?
A. 저장 또는 서버 전송 여부에 따라 다르다. 로컬에서 익명화된 전투 통계만 사용하더라도 수집 항목과 사용 목적을 설정 또는 개인정보 고지에서 분명히 안내하는 편이 좋다.
정리
AI 라이벌·보스의 플레이어 스타일 복제는 행동을 베끼는 기술이 아니라 전투 성향을 읽을 수 있는 규칙으로 번역하는 디자인 작업이다. 적은 수의 명확한 신호부터 시작하고 복제율과 행동 예산으로 상한을 두며 텔레그래프를 통해 대응 가능한 적응을 보여 주면 라이벌은 불공정한 치트 AI가 아니라 기억에 남는 거울 같은 적이 된다.