ElevenLabs로 구축하는 게임용 다국어 음성 더빙 파이프라인
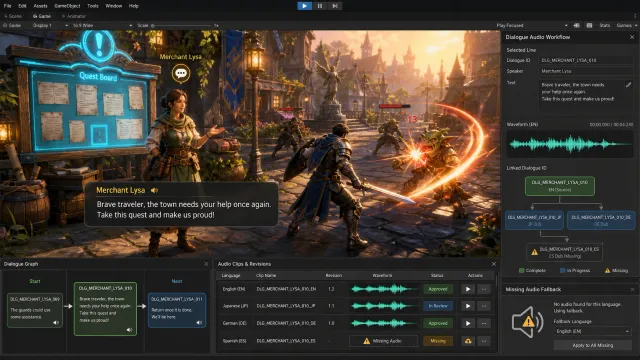
대사 데이터에서 언어별 음성 파일과 Unity 메타데이터를 생성하는 ElevenLabs 기반 배치 파이프라인을 설계한다. 번역·발음·검수·재생을 분리해 반복 생성과 현지화 품질 문제를 줄이는 방법을 다룬다.
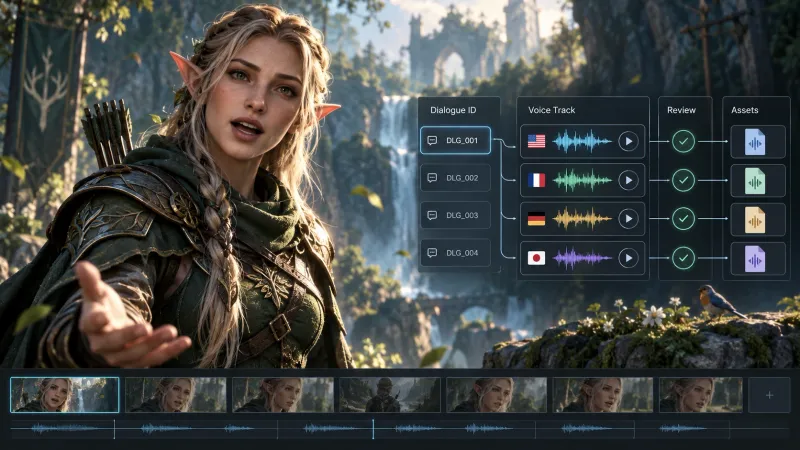
왜 음성 더빙을 파이프라인으로 다뤄야 할까
게임의 더빙은 음성 파일을 한 번 만드는 작업으로 끝나지 않는다. 원문 대사가 수정되고 번역이 바뀌며 발음 오류가 발견되고 성우와 캐릭터의 연결도 달라진다. 이때 제작자가 파일을 수동으로 내려받아 이름을 붙이면 어떤 대사와 어떤 설정으로 생성했는지 추적하기 어렵다.
ElevenLabs의 텍스트 음성 변환 API는 텍스트와 voice_id를 받아 오디오를 반환한다. 공식 Python SDK는 elevenlabs 패키지로 제공된다. 따라서 게임 프로젝트에서는 API 호출 자체보다 대사 식별자, 언어, 음성, 생성 설정, 검수 상태를 함께 관리하는 구조가 중요하다. ElevenLabs API 소개와 TTS API 레퍼런스를 먼저 확인해 두면 좋다.
flowchart LR
    A[원문 대사 데이터] --> B[번역 및 현지화 검수]
    B --> C[발음 규칙 적용]
    C --> D[ElevenLabs 배치 생성]
    D --> E[오디오·매니페스트 저장]
    E --> F[듣기 검수]
    F -->|수정 필요| B
    F -->|승인| G[Unity Addressables 또는 빌드 리소스]
파이프라인의 입력과 출력은 사람이 읽을 수 있어야 한다. API 키는 Unity 클라이언트에 넣지 않고 에디터 도구나 CI에서 실행되는 생성 스크립트의 환경 변수로만 전달한다.
대사 데이터의 최소 단위
대사마다 변하지 않는 ID를 부여하고 언어별 텍스트와 캐릭터 음성을 분리한다. 파일명에 번역문을 넣는 방식보다 대사 수정에 강하고 저장 위치도 결정적이다.
{
  "lines": [
    {
      "id": "intro_guard_001",
      "speaker": "guard",
      "texts": {
        "ko": "거기서 멈춰. 더는 들어갈 수 없어.",
        "en": "Stop right there. You cannot go any further.",
        "ja": "そこまでだ。これ以上は通さない。"
      }
    }
  ],
  "voices": {
    "guard": {
      "ko": "VOICE_ID_FOR_KOREAN",
      "en": "VOICE_ID_FOR_ENGLISH",
      "ja": "VOICE_ID_FOR_JAPANESE"
    }
  }
}
같은 캐릭터라도 언어별로 다른 음성을 지정할 수 있게 두는 편이 안전하다. 지원 언어로 텍스트를 입력하면 모델이 언어를 인식하지만 자연스러운 결과를 위해서는 대상 언어와 지역에 맞는 억양을 가진 음성을 선택하는 것이 권장된다. ElevenLabs는 현재 모델마다 지원 언어와 특성이 다르므로 프로젝트에서 선택한 모델과 음성 ID를 매니페스트에 고정해 두자. TTS 지원 언어와 모델 비교를 참고할 수 있다.
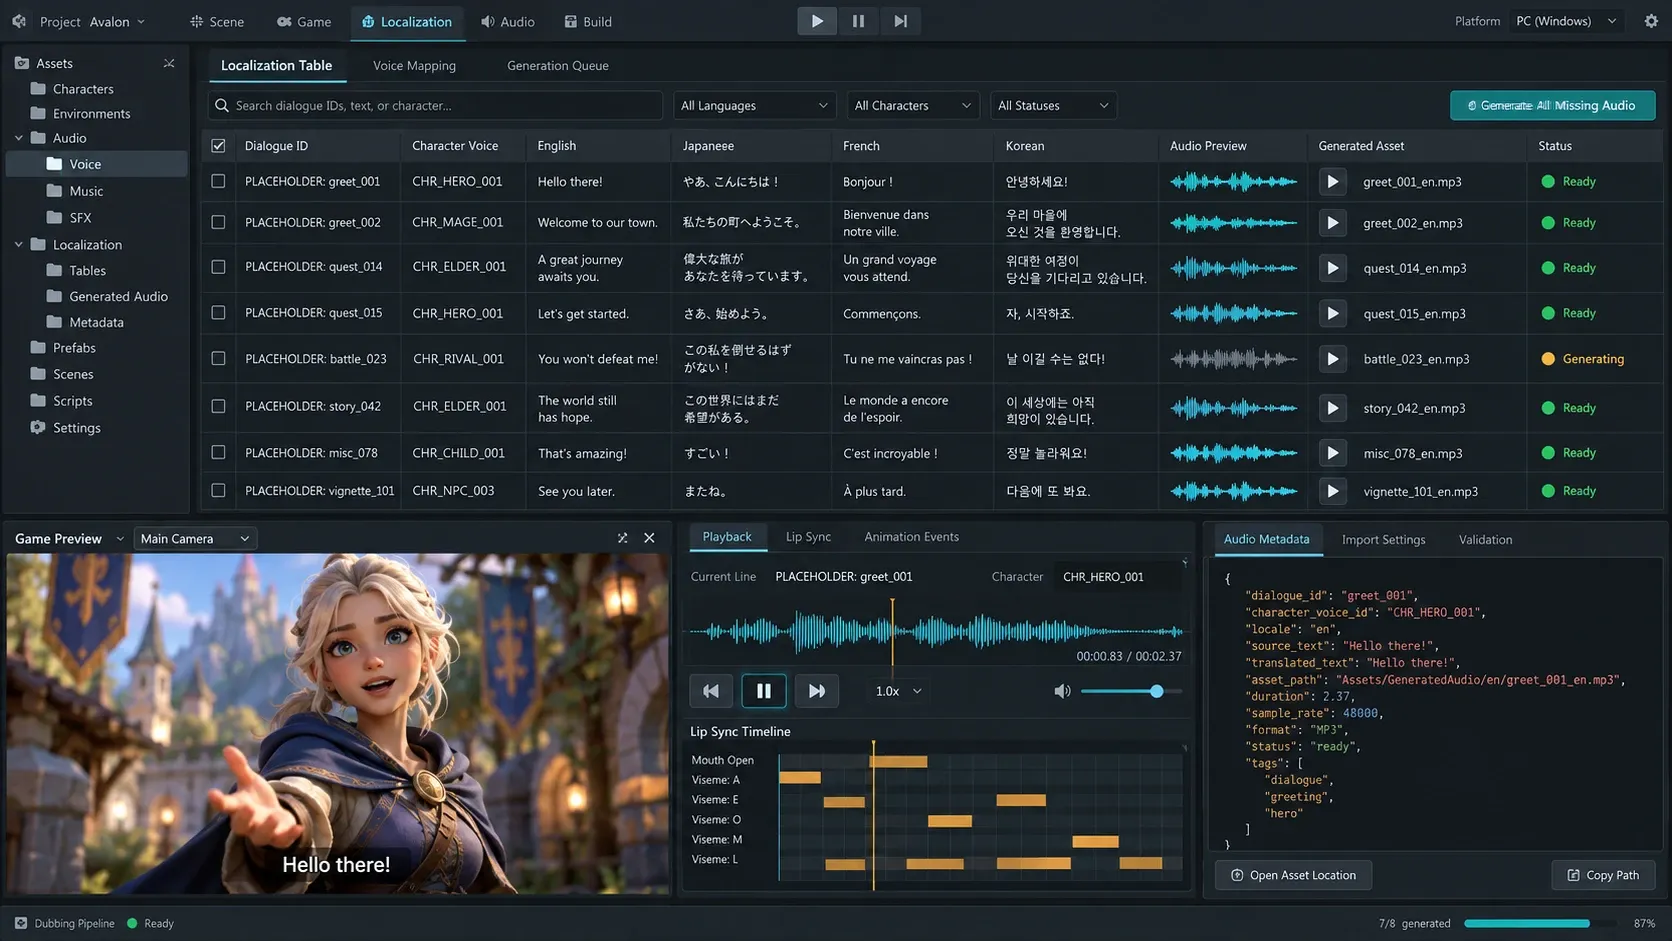
생성 서버 또는 배치 스크립트 만들기
다음 예제는 JSON 대사표를 읽어 MP3를 생성하고 재생에 필요한 매니페스트를 함께 기록한다. 클라이언트 런타임이 아니라 로컬 제작 도구나 CI 작업에서 실행하는 코드다.
먼저 패키지를 설치하고 API 키를 환경 변수에 둔다.
pip install elevenlabs python-dotenvELEVENLABS_API_KEY=발급받은_비밀_키import json
import os
from pathlib import Path
from dotenv import load_dotenv
from elevenlabs import VoiceSettings
from elevenlabs.client import ElevenLabs
load_dotenv()
client = ElevenLabs(api_key=os.environ["ELEVENLABS_API_KEY"])
MODEL_ID = "eleven_multilingual_v2"
OUTPUT_ROOT = Path("GeneratedVoice")
def write_audio(audio_chunks, output_path: Path) -> None:
output_path.parent.mkdir(parents=True, exist_ok=True)
with output_path.open("wb") as output:
for chunk in audio_chunks:
if chunk:
output.write(chunk)
def generate_line(text: str, voice_id: str, output_path: Path) -> None:
audio = client.text_to_speech.convert(
text=text,
voice_id=voice_id,
model_id=MODEL_ID,
output_format="mp3_44100_128",
voice_settings=VoiceSettings(
stability=0.55,
similarity_boost=0.75,
style=0.0,
use_speaker_boost=True,
speed=1.0,
),
)
write_audio(audio, output_path)
def main() -> None:
source = json.loads(Path("dialogue.json").read_text(encoding="utf-8"))
manifest = {"model": MODEL_ID, "clips": {}}
for line in source["lines"]:
for language, text in line["texts"].items():
voice_id = source["voices"][line["speaker"]][language]
relative_path = Path(language) / f"{line['id']}.mp3"
generate_line(text, voice_id, OUTPUT_ROOT / relative_path)
manifest["clips"].setdefault(line["id"], {})[language] = str(relative_path)
(OUTPUT_ROOT / "voice-manifest.json").write_text(
json.dumps(manifest, ensure_ascii=False, indent=2),
encoding="utf-8",
)
if __name__ == "__main__":
main()eleven_multilingual_v2는 긴 대사에 안정적인 다국어 모델로 소개되어 있어 배치 더빙의 출발점으로 적합하다. 대화 중 즉시 재생하는 기능이라면 지연 시간이 더 짧은 Flash 계열과 스트리밍을 따로 평가한다. 모델의 문자 제한과 사용 가능한 출력 형식은 바뀔 수 있으므로 빌드 도구에 상수로 박아 두기보다 설정 파일로 관리하는 편이 낫다. 공식 스트리밍 가이드에는 SDK의 파일 저장 방식도 나와 있다.
재생 파일이 아닌 빌드 산출물로 관리하기
생성 결과만 저장하면 재현성이 부족하다. 매니페스트에는 최소한 다음 정보를 남긴다.
- 대사 ID와 언어 코드
- 원문 또는 텍스트 해시
voice_id, 모델 ID, 음성 설정- 생성 시각, API 요청 ID, 문자 비용
- 검수 상태와 검수 메모
텍스트 해시가 기존 기록과 같으면 API 요청을 건너뛸 수 있다. 음성 설정이나 모델이 바뀌었을 때도 해시에 포함하면 필요한 파일만 다시 만들 수 있다. ElevenLabs의 raw response에서는 요청 ID와 문자 비용 같은 헤더 메타데이터를 읽을 수 있어 비용 추적에 활용할 수 있다. 생성 비용 메타데이터 안내를 참고하자.
Unity에서는 생성된 폴더를 Assets/GeneratedVoice 아래로 복사하거나 Addressables의 별도 그룹으로 등록한다. 매니페스트의 lineId와 현재 언어 코드를 키로 사용하면 게임 코드가 파일 경로를 알 필요가 없다.
using System.Collections.Generic;
using UnityEngine;

public sealed class LocalizedVoiceTable : MonoBehaviour
{
    [System.Serializable]
    public class Entry
    {
        public string lineId;
        public string language;
        public AudioClip clip;
    }

    [SerializeField] private List<Entry> entries = new List<Entry>();
    private Dictionary<string, AudioClip> lookup;

    private void Awake()
    {
        lookup = new Dictionary<string, AudioClip>();
        foreach (var entry in entries)
            lookup[$"{entry.lineId}:{entry.language}"] = entry.clip;
    }

    public bool TryGet(string lineId, string language, out AudioClip clip)
    {
        return lookup.TryGetValue($"{lineId}:{language}", out clip);
    }
}
실제 프로젝트에서는 이 테이블을 수동으로 채우기보다 생성 스크립트가 Unity 에디터용 임포터 입력을 만들고 에디터 코드가 Addressables 주소와 AudioClip을 등록하도록 연결하는 방식이 낫다. 그러면 파일을 다시 생성해도 대사 키는 유지된다.
현지화 품질을 좌우하는 지점
번역문을 그대로 TTS에 넣는다고 자연스러운 더빙이 자동으로 완성되지는 않는다. 특히 UI 문구를 대사로 재사용하거나 고유명사와 약어가 많은 게임은 발음 검수가 필요하다.
텍스트는 화면 번역과 분리한다
자막에 맞는 짧은 문장과 실제로 읽기 좋은 문장은 다를 수 있다. 쉼표, 줄바꿈, 기호는 언어마다 휴지와 억양에 다른 영향을 준다. 따라서 subtitle과 spokenText를 분리하고 음성 생성에는 spokenText만 전달한다.
고유명사에는 발음 사전을 쓴다
캐릭터명, 지명, 약어처럼 반복되는 단어는 발음 사전으로 일관성을 높일 수 있다. API 요청에는 최대 3개의 발음 사전을 지정할 수 있지만, 지원하는 규칙 유형은 모델마다 다르다. 예를 들어 eleven_multilingual_v2에서는 음소 태그 대신 별칭(alias) 규칙을 사용하고, 사전으로 해결되지 않는 표현은 해당 언어의 표기나 문장 구조를 조정한 뒤 사람이 듣고 확인한다.
길이를 측정한다
애니메이션 립싱크나 컷신 타이밍이 고정되어 있다면 언어별 음성 길이가 허용 범위를 벗어나는지 검사한다. 원본 길이를 , 생성 음성 길이를 라고 하면 상대 차이는 다음처럼 기록할 수 있다.
r이 팀에서 정한 임계값보다 크면 번역 축약, 문장 분할, 재녹음 또는 컷신 타이밍 조정을 검토한다. 음성 속도 조절은 보조 수단이다. 지나친 속도 변경은 발음과 감정을 해칠 수 있다.
운영 시 확인할 체크리스트
- API 키는 저장소와 게임 클라이언트에 포함하지 않는다.
- 동의와 권리를 확인한 음성만 복제하거나 배포한다.
- 개발용과 출시용 프로젝트를 분리하고 생성 비용과 실패 요청을 기록한다.
- API 오류와 재시도에는 지수 백오프를 적용하고 이미 성공한 파일은 다시 요청하지 않는다.
- 모든 언어에서 대표 대사뿐 아니라 전투 중 짧은 감탄사, 숫자, 고유명사, 감정 변화가 큰 대사를 표본 검수한다.
- API 및 SDK 버전을 잠그고 모델·음성 변경 시 일부 대사로 회귀 테스트를 실행한다.
핵심은 AI 음성 품질을 한 번의 설정으로 해결하려 하지 않는 것이다. 결정적인 대사 ID, 언어별 음성 정책, 재생성 가능한 메타데이터, 사람이 듣는 검수 단계를 갖추면 대사가 늘어나도 다국어 더빙을 예측 가능하게 운영할 수 있다.