게임 출시 국가별 경쟁작 가격 변동 크롤링과 현지화 가격 최적화 AI 추천
Steam 게임 출시를 준비하면서 국가별 경쟁작 가격을 비교하고 현지화 가격을 정하는 방법을 정리합니다. 공개 데이터 수집, 환율·할인 보정, 가격 탄력성 모델, AI 추천과 정책·오차 관리까지 실무 흐름을 다룹니다.
핵심 요약
Steam 게임의 국가별 경쟁작 가격은 cc 국가 코드와 통화 단위를 기준으로 수집한 뒤 정가, 할인 판매가, 환율, 세금 표시 여부를 분리해 비교해야 합니다. 현지화 가격 최적화 AI는 경쟁작 중앙값과 가격 탄력성, 구매력 지수, 출시 할인 정책을 함께 반영하고 최종 추천 전에는 가격 상한·하한과 퍼블리셔 계약 조건을 검증해야 합니다.
이 글에서는 공개 Steam Store 데이터로 국가별 가격 변동을 수집하고 정규화하는 방법부터 CatBoost, 베이지안 계층 모델, 제약 최적화를 결합한 추천 구조까지 설명합니다.
왜 국가별 경쟁작 가격을 추적해야 하는가?
같은 게임이라도 국가별 가격은 단순히 환율을 곱한 값과 다릅니다. Steam은 지역별 구매력, 세금, 결제 환경, 시장 경쟁도, 플랫폼 정책을 고려해 권장 가격과 실제 판매 가격을 다르게 운영할 수 있습니다.
예를 들어 미국에서 19.99달러인 게임이 한국에서 단순 환율 환산값으로 27,000원이 된다고 해서 반드시 27,000원이 적정한 것은 아닙니다. 같은 장르와 비슷한 인지도의 경쟁작이 24,000원에 형성되어 있다면 27,000원은 구매자가 체감하는 가격 지수에서 불리할 수 있습니다.
가격 모니터링의 목적은 가장 싼 가격을 찾는 것이 아닙니다. 다음 세 가지 질문에 답하는 것이 핵심입니다.
- 우리 게임의 국가별 가격 포지션은 경쟁작 대비 어느 수준인가?
- 할인 기간과 할인 폭은 경쟁작의 판매 전략과 어떻게 다른가?
- 가격을 조정했을 때 예상 매출과 판매량은 어떻게 변하는가?
국가별 Steam 가격 데이터는 어떻게 수집할까?
공개 Store 데이터와 공식 도구를 어떻게 구분해야 하는가?
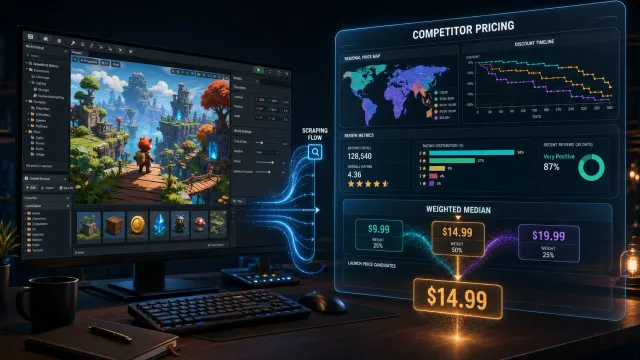
경쟁작 가격 조사는 공개 Steam Store 페이지 또는 공개 Store API 응답을 기반으로 설계할 수 있습니다. 다음 예시는 appdetails 엔드포인트에 cc 국가 코드를 전달하는 방식입니다.
https://store.steampowered.com/api/appdetails?appids=APP_ID&cc=kr&l=english
다만 공개 접근이 곧 무제한 자동 수집을 의미하지는 않습니다. 운영 전에 Steam의 이용약관, robots 정책, 요청 제한, 퍼블리셔 계약을 확인해야 합니다. 로그인 세션, CAPTCHA 우회, 비공개 엔드포인트, 과도한 병렬 요청은 사용하지 않는 것이 안전합니다.
국가 코드와 통화 매핑은 코드에 직접 흩어 놓지 말고 설정 테이블로 관리합니다.
| 국가 | 국가 코드 예시 | 주요 비교 통화 | 운영 시 확인할 항목 |
|---|---|---|---|
| 대한민국 | kr | KRW | 부가세 표시 방식, 원화 가격 단위 |
| 미국 | us | USD | 정가와 할인 가격, 센트 단위 |
| 일본 | jp | JPY | 엔 단위 반올림, 지역별 구매력 |
| 영국 | gb | GBP | VAT 포함 여부 |
| 유로존 | de, fr 등 | EUR | 국가별 표시 차이 |
| 브라질 | br | BRL | 지역 결제 환경과 변동성 |
국가 코드와 실제 가격 표시 결과는 시점에 따라 달라질 수 있으므로 수집 결과에 반드시 fetched_at_utc를 저장해야 합니다.
최소 수집 스키마는 무엇인가?
가격 분석에 필요한 필드는 다음과 같습니다.
| 필드 | 설명 |
|---|---|
app_id | Steam 애플리케이션 식별자 |
country_code | kr, us, jp 같은 국가 코드 |
currency | 응답에 포함된 통화 코드 |
list_price_minor | 최저 통화 단위 기준 정가 |
final_price_minor | 할인 적용 후 판매 가격 |
discount_percent | 현재 할인율 |
is_free | 무료 게임 여부 |
availability | 판매 가능, 지역 제한, 가격 없음 등의 상태 |
fetched_at_utc | UTC 기준 수집 시각 |
source_type | Store API, Store HTML, 파트너 데이터 등 |
가격이 없다고 해서 곧바로 0원으로 처리하면 안 됩니다. 무료 게임, DLC, 지역 판매 제한, 데이터 누락은 서로 다른 상태이므로 availability와 is_free를 분리해야 합니다.
Python으로 국가별 가격을 수집하는 기본 예제
다음 코드는 조사 프로토타입을 위한 최소 예제입니다. 실제 운영에서는 캐시, 재시도 정책, 변경 감지, 요청 제한, 데이터베이스 저장을 추가해야 합니다.
from datetime import datetime, timezone
import time
import requests

COUNTRY_CODES = {
    '대한민국': 'kr',
    '미국': 'us',
    '일본': 'jp',
    '영국': 'gb',
    '독일': 'de',
}


def fetch_price(app_id: int, country_code: str) -> dict | None:
    url = 'https://store.steampowered.com/api/appdetails'
    params = {
        'appids': app_id,
        'cc': country_code,
        'l': 'english',
    }
    headers = {
        'User-Agent': 'price-research/1.0'
    }

    response = requests.get(url, params=params, headers=headers, timeout=10)
    response.raise_for_status()
    payload = response.json()
    app_record = payload.get(str(app_id), {})

    if not app_record.get('success'):
        return None

    data = app_record.get('data', {})
    price = data.get('price_overview')

    if price is None:
        return {
            'app_id': app_id,
            'country_code': country_code,
            'availability': 'no_price',
            'is_free': bool(data.get('is_free')),
            'fetched_at_utc': datetime.now(timezone.utc).isoformat(),
        }

    return {
        'app_id': app_id,
        'country_code': country_code,
        'currency': price.get('currency'),
        'list_price_minor': price.get('initial'),
        'final_price_minor': price.get('final'),
        'discount_percent': price.get('discount_percent', 0),
        'availability': 'priced',
        'is_free': bool(data.get('is_free')),
        'fetched_at_utc': datetime.now(timezone.utc).isoformat(),
    }


for app_id in [123456, 234567]:
    for country_code in COUNTRY_CODES.values():
        try:
            print(fetch_price(app_id, country_code))
        except requests.RequestException as error:
            print({'app_id': app_id, 'country_code': country_code, 'error': str(error)})
        time.sleep(2)
이 코드는 검색 결과를 그대로 가격 추천에 넣지 않습니다. 수집 시각별 스냅샷을 저장하고 정가와 할인 가격을 모두 보존해야 가격 변동과 할인 패턴을 분석할 수 있습니다.
가격 데이터를 어떻게 정규화해야 하는가?
정가와 할인 판매가를 왜 분리해야 하는가?
경쟁작이 30% 할인 중인 시점의 가격만 비교하면 출시 정가를 잘못 추정할 수 있습니다. 다음 필드를 별도로 계산합니다.
base_price: 할인 전 정가sale_price: 현재 할인 적용가discount_depth: 할인율days_since_last_discount: 직전 할인 종료 후 경과일price_change_event: 정가 변경 여부
출시 가격을 결정할 때는 base_price를 중심으로 비교하고 출시 프로모션을 설계할 때는 sale_price와 discount_depth를 사용합니다.
환율 비교의 기준은 무엇인가?
환율은 하루 단위로 크게 움직일 수 있으므로 한 시점의 환율만 사용하면 가격 지수가 불안정해집니다. 조사 목적에 따라 다음 중 하나를 선택합니다.
| 환율 기준 | 적합한 용도 | 주의점 |
|---|---|---|
| 당일 환율 | 빠른 시장 모니터링 | 일시적 변동에 민감 |
| 30일 평균 환율 | 출시 가격 검토 | 급격한 통화 변화를 늦게 반영 |
| 내부 기준 환율 | 계약·예산 관리 | 실제 소비자 체감과 차이 가능 |
현지 가격을 기준 통화로 변환하는 기본식은 다음과 같습니다.
여기서 은 국가 에서 경쟁작 의 현지 가격이고 는 현지 통화를 기준 통화로 바꾸는 환율입니다. 실제 추천에서는 환율 환산값만 보지 말고 국가별 현지 가격 자체도 함께 사용해야 합니다.
경쟁작 중앙값과 가격 지수는 어떻게 계산하는가?
극단적으로 비싼 프리미엄 타이틀이나 무료에 가까운 타이틀이 포함되면 평균이 왜곡됩니다. 장르, 플레이 시간, 얼리 액세스 여부, DLC 포함 여부가 비슷한 경쟁작을 묶은 뒤 중앙값을 계산하는 편이 안정적입니다.
I_r가 1보다 크면 해당 국가에서 우리 게임이 경쟁작 중앙값보다 비싸고 1보다 작으면 상대적으로 저렴하다는 뜻입니다. 다만 가격 지수 하나만으로 가격을 결정하지 말고 리뷰 평점, 브랜드 인지도, 콘텐츠 규모, 출시 할인율을 함께 고려해야 합니다.
현지화 가격 최적화 AI는 어떤 구조로 설계해야 하는가?
가격 추천은 LLM에게 숫자를 직접 생성하게 하는 방식보다 수치 모델과 언어 모델의 역할을 분리하는 것이 좋습니다.
| 구성 요소 | 담당 역할 | 추천 기술 |
|---|---|---|
| 데이터 파이프라인 | 가격·환율·할인·판매 지표 수집 | Python, PostgreSQL, dbt |
| 피처 생성 | 가격 지수, 할인 빈도, 변동성 계산 | pandas, SQL |
| 수요 예측 | 국가별 판매량 또는 전환율 예측 | CatBoost, XGBoost, Bayesian hierarchical model |
| 가격 탐색 | 후보 가격별 매출·이익 비교 | grid search, constrained optimization |
| 설명 생성 | 추천 근거와 위험 요약 | LLM with structured JSON output |
| 검증 | 계약·정책·수동 승인 확인 | rule engine, audit log |
국가별 가격 탄력성은 어떻게 추정하는가?
가격 탄력성은 가격이 변할 때 수요가 얼마나 변하는지를 나타냅니다. 로그-로그 모델의 기본 형태는 다음과 같습니다.
- : 국가 의 기간 판매량 또는 구매 전환 수
- : 현지 판매 가격
- : 할인율, 트레일러 노출, 리뷰 수, 시즌 이벤트 등 통제 변수
- : 국가별 가격 탄력성
일반적으로 는 음수로 추정되지만 데이터가 적거나 할인 이벤트가 가격과 동시에 발생하면 인과관계를 잘못 해석할 수 있습니다. 따라서 출시 전에는 국가별 독립적인 정확한 탄력성을 주장하기보다 장르·규모가 비슷한 타이틀의 사전분포를 사용하는 베이지안 계층 모델이 유용합니다.
추천 가격은 어떻게 계산하는가?
가격 후보를 여러 개 만들고 예상 매출과 이익을 비교합니다. 간단한 추천식은 다음과 같습니다.
- : 국가별 경쟁작 가격 중앙값
- : 콘텐츠 규모와 브랜드 포지션을 반영한 프리미엄 계수
- : 출시 할인 또는 구매 장벽 완화 계수
- : 내부 가격 하한과 상한
실제 모델에서는 후보 가격마다 다음 지표를 계산합니다.
- 예상 판매량
- 예상 매출
- 플랫폼 수수료와 세금 차감 후 순매출
- 환불률 변화 가능성
- 퍼블리셔와 개발사의 수익 배분액
- 가격 변경으로 발생하는 기존 구매자 보상 위험
LLM은 이 결과를 바탕으로 추천 가격, 추천 이유, 신뢰도, 주의할 데이터, 수동 검토 필요 여부를 JSON으로 설명하게 합니다. 숫자 계산과 계약 조건 검증은 결정론적 코드가 담당해야 합니다.
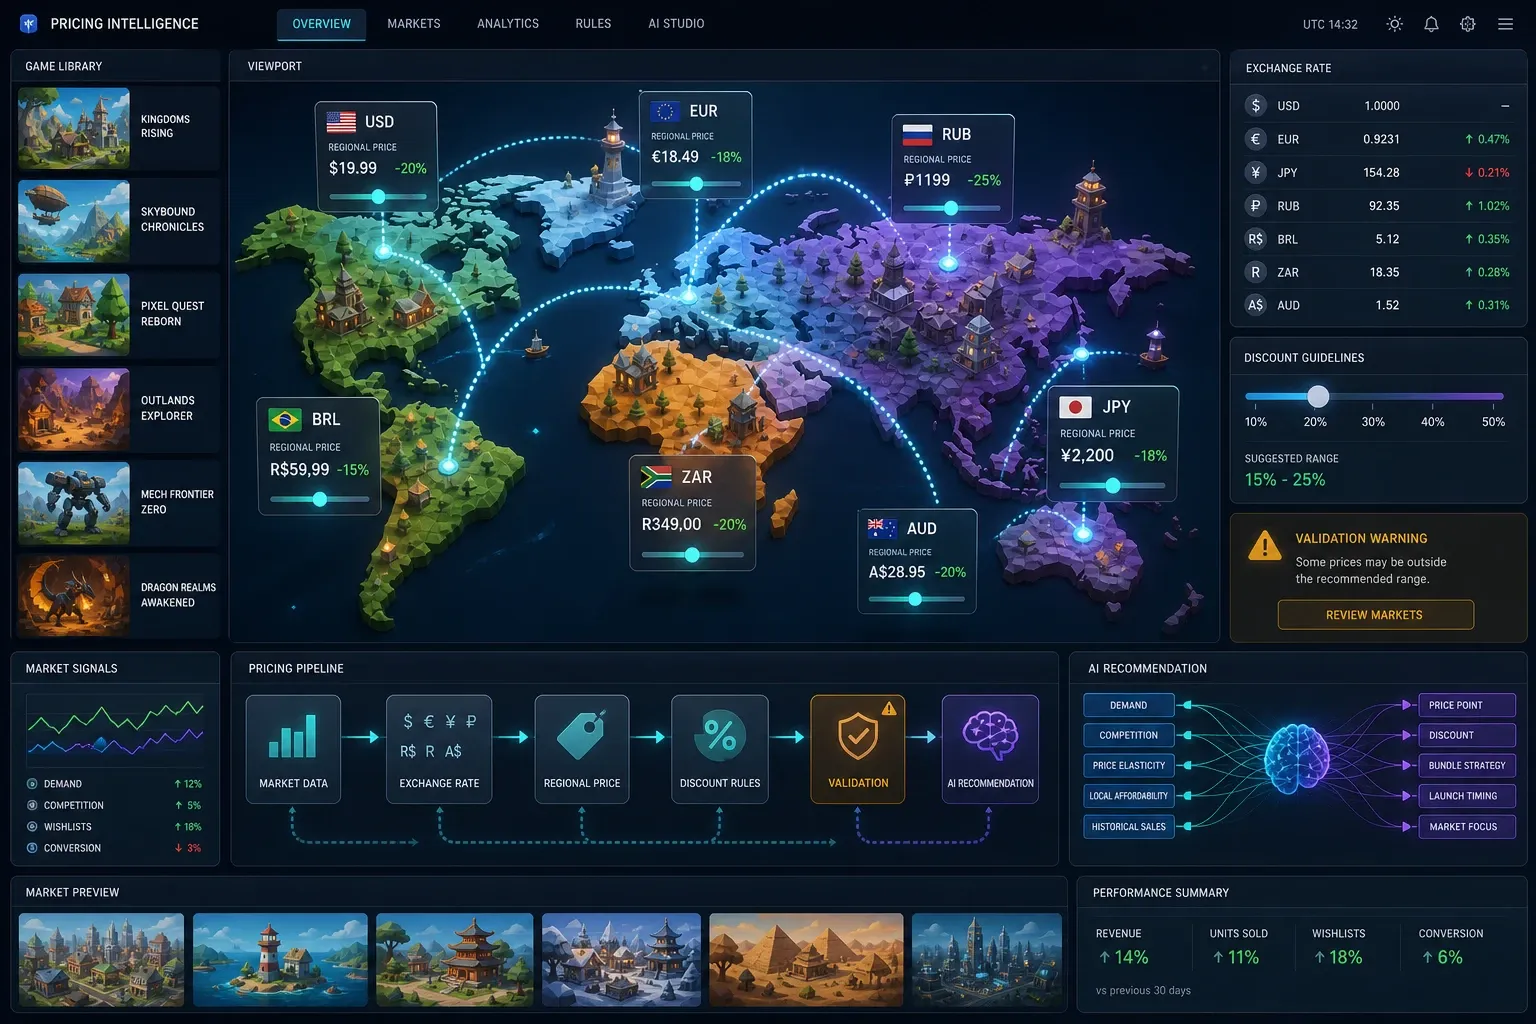
국가별 가격 추천 파이프라인을 어떻게 운영할까?
flowchart LR
    A[국가 목록] --> B[경쟁작 식별]
    B --> C[Steam Store 수집]
    C --> D[환율·세금·할인 정규화]
    D --> E[가격 지표 생성]
    E --> F[수요 모델 추론]
    F --> G[가격 상한·하한 검증]
    G --> H[추천 가격과 설명]
1단계: 경쟁작군을 정의한다
경쟁작은 장르만으로 고르지 않습니다. 다음 기준으로 비교군을 고정합니다.
- 핵심 장르와 플랫폼
- 싱글플레이 또는 멀티플레이 구조
- 예상 플레이 시간
- 얼리 액세스 여부
- 기본 게임과 DLC 구성
- 출시 후 경과 기간
- 리뷰 수와 최근 리뷰 평점
비교군이 자주 바뀌면 가격 변동이 경쟁작의 변화인지 비교군 변경 때문인지 알기 어렵습니다. 비교군 버전과 제외 사유를 함께 기록하세요.
2단계: 국가별 스냅샷을 수집한다
처음부터 모든 국가를 매분 수집할 필요는 없습니다. 출시 준비 단계에서는 하루 1회 또는 주요 할인 이벤트 전후 수집으로 시작하고 데이터가 안정되면 빈도를 조정합니다.
수집 작업에는 다음 운영 규칙을 둡니다.
- 요청 간격과 최대 동시 요청 수를 제한한다.
- 동일한 URL과 국가 조합은 캐시한다.
- 응답 원문 또는 해시를 보존해 변경 원인을 추적한다.
- 실패 시 지수 백오프를 적용하되 무한 재시도하지 않는다.
- 가격이 없는 응답을 0원으로 변환하지 않는다.
3단계: 가격 변동 이벤트를 탐지한다
각 스냅샷을 이전 스냅샷과 비교해 다음 이벤트를 분류합니다.
- 정가 변경
- 할인 시작
- 할인 종료
- 할인 폭 변경
- 지역 판매 중단
- 통화 또는 표시 형식 변경
단순 차액뿐 아니라 변동률과 유지 기간을 계산하면 경쟁작의 할인 캘린더를 추정할 수 있습니다.
가격이 작은 국가에서는 반올림만으로 변동률이 크게 보일 수 있으므로 최소 가격 단위와 통화 자릿수를 함께 보정해야 합니다.
4단계: 추천 가격 후보를 생성한다
후보 가격은 임의의 실수값이 아니라 국가별 통화 단위와 플랫폼 가격 관행에 맞춘 목록으로 생성합니다. 예를 들어 원화는 100원 또는 1,000원 단위 후보를 만들고 엔화는 100엔 단위 후보를 만들 수 있습니다.
각 후보에 대해 다음 제약을 적용합니다.
- 플랫폼이 허용하는 가격 단위
- 퍼블리셔 계약상의 최소·최대 가격
- 국가별 최저 가격 정책
- 출시 할인율과 정가의 일관성
- 기존 얼리 액세스 구매자 보상 정책
- 번들 또는 DLC 가격과의 상대적 균형
5단계: 사람의 승인을 거쳐 배포한다
추천 결과를 바로 스토어에 반영하지 말고 승인 큐를 둡니다. 승인 화면에는 현재 가격, 추천 가격, 경쟁작 중앙값, 예상 매출 변화, 데이터 수집 시각, 신뢰도, 정책 경고를 함께 표시합니다.
신뢰도가 낮아지는 대표적인 조건은 다음과 같습니다.
- 최근 가격 데이터가 부족한 경우
- 비교 가능한 경쟁작이 적은 경우
- 가격과 판매량이 동시에 변해 인과관계가 불분명한 경우
- 환율 변동성이 비정상적으로 큰 경우
- 지역 제한이나 데이터 누락이 반복되는 경우
이때 AI는 숫자를 강제로 제시하기보다 추가 데이터 수집 필요 또는 수동 검토 필요를 반환해야 합니다.
현지화 가격 전략에서 자주 발생하는 오류는 무엇인가?
환율만 곱해서 가격을 정하는 오류
환율은 기준값일 뿐 최종 가격이 아닙니다. 구매력, 경쟁작 가격대, 세금, 결제 심리, 현지 통화의 최소 가격 단위를 함께 고려해야 합니다.
현재 할인 가격을 출시 정가로 사용하는 오류
할인 중인 경쟁작의 판매가를 정가 비교에 사용하면 우리 게임의 포지셔닝이 왜곡됩니다. 정가와 할인 가격을 각각 분석하고 할인 빈도까지 기록해야 합니다.
국가별 가격을 너무 자주 바꾸는 오류
가격 변경은 기존 구매자와 커뮤니티의 신뢰에 영향을 줄 수 있습니다. 특별한 시장 변화가 없다면 변경 주기와 승인 기준을 먼저 정하고 예외적인 경우에만 조정합니다.
LLM의 숫자 추천을 검증 없이 사용하는 오류
LLM은 누락된 국가, 잘못된 통화, 오래된 가격을 그럴듯하게 설명할 수 있습니다. 모델 입력은 스키마 검증을 거치고 출력에는 JSON Schema를 적용하며 최종 가격은 규칙 엔진을 통과시켜야 합니다.
경쟁작 수가 적은 국가에서 과도하게 일반화하는 오류
데이터가 적은 국가의 중앙값은 불안정합니다. 국가별 결과에 표본 수와 신뢰 구간을 표시하고 유사 국가군의 정보를 부분적으로 공유하는 계층 모델을 사용하세요.
실무용 추천 결과 포맷은 어떻게 만들까?
가격 담당자와 퍼블리셔가 함께 검토할 수 있도록 추천 결과를 다음처럼 구조화하면 좋습니다.
{
  "country_code": "kr",
  "recommended_list_price": 24000,
  "launch_discount_percent": 10,
  "competitor_median": 25000,
  "relative_price_index": 0.96,
  "expected_revenue_change": 0.07,
  "confidence": 0.72,
  "reasons": [
    "비교군 8개 타이틀의 정가 중앙값보다 4% 낮음",
    "콘텐츠 규모를 반영한 가격 프리미엄이 제한적임"
  ],
  "warnings": [
    "최근 30일 내 경쟁작 할인 이벤트가 많음"
  ],
  "requires_manual_review": true
}expected_revenue_change는 확정 수익이 아니라 모델 추정치라는 점을 화면과 보고서에 명확히 표시해야 합니다. 또한 추천 당시 사용한 데이터 버전과 모델 버전을 저장해야 나중에 결과를 재현할 수 있습니다.
자주 묻는 질문 (FAQ)
Steam 국가별 가격 크롤링은 합법적으로 운영할 수 있는가?
공개 데이터라도 자동 수집에는 서비스 이용약관과 요청 제한이 적용될 수 있습니다. 운영 전 Steam의 최신 정책과 계약을 확인하고 낮은 요청 빈도, 캐시, 공개 범위 내 데이터, 명확한 User-Agent를 사용해야 합니다. 정책 해석이 필요한 경우 법률 자문을 받는 것이 안전합니다.
국가별 게임 가격을 추천할 때 AI만 사용해도 되는가?
권장하지 않습니다. 가격 계산은 통계 모델과 제약 최적화로 처리하고 LLM은 추천 이유와 위험 요약을 생성하는 역할로 제한하는 편이 안정적입니다. 계약 조건과 최종 배포는 반드시 규칙 엔진과 담당자 승인을 거쳐야 합니다.
판매량 데이터가 없으면 현지화 가격 최적화가 가능한가?
가능하지만 정밀한 가격 탄력성을 추정하기는 어렵습니다. 초기에는 경쟁작 가격 중앙값, 구매력 지표, 장르별 사전분포를 이용한 콜드 스타트 추천을 만들고 출시 후 가격·전환·할인 데이터를 축적해 모델을 업데이트해야 합니다.
정리
국가별 경쟁작 가격 크롤링의 핵심은 가격을 많이 모으는 것이 아니라 같은 기준으로 비교할 수 있게 정규화하는 데 있습니다. app_id, 국가 코드, 정가, 할인 가격, 통화, 수집 시각을 보존하고 환율과 할인 이벤트를 분리하면 가격 변동의 원인을 추적할 수 있습니다.
현지화 가격 최적화 AI는 경쟁작 중앙값을 출발점으로 사용하되 가격 탄력성, 콘텐츠 포지션, 플랫폼 수수료, 세금, 퍼블리셔 계약 조건을 함께 반영해야 합니다. 마지막으로 AI 추천은 자동 배포 명령이 아니라 근거와 불확실성을 포함한 의사결정 자료로 운영할 때 출시 리스크를 줄일 수 있습니다.