Unity ML-Agents 강화학습으로 몬스터 지능형 이동·장애물 회피 구현하기
Unity ML-Agents 강화학습 모듈로 몬스터가 목표를 추적하면서 장애물을 회피하도록 구현한다. 관측, 연속 행동, 보상 설계, PPO 학습 설정과 디버깅 기준을 C# 예제로 정리한다.
핵심 요약
Unity ML-Agents에서 몬스터의 지능형 이동은 목표 방향·목표 거리·장애물 감지값·현재 속도를 관측으로 제공하고 전진량과 회전량을 연속 행동으로 학습시키면 구현할 수 있다. 목표에 가까워지는 보상은 작게 누적하고 충돌·정지·경계 이탈에는 즉시 패널티를 주어 PPO 정책이 ‘가까운 길’보다 ‘안전하게 도달하는 경로’를 선택하게 만든다.
이 글은 Unity 2022.3 LTS 계열과 com.unity.ml-agents 2.x API의 Agent, VectorSensor, ActionBuffers 기준으로 작성한다. 패키지 버전이 다르더라도 관측·행동·보상 설계 원칙은 동일하다.
Unity ML-Agents 몬스터 AI는 왜 일반 추적보다 장애물 회피에 적합한가?
NavMeshAgent는 정적인 네비게이션 메시 위에서 목적지까지의 경로 탐색에 강하다. 반면 강화학습 기반 이동은 위험 구역, 움직이는 장애물, 거리 유지, 공격 사거리 같은 게임 규칙을 보상으로 함께 학습할 수 있다.
| 방식 | 강점 | 주의할 점 | 적합한 상황 |
|---|---|---|---|
NavMeshAgent | 빠른 구현, 안정적인 경로 탐색 | 설계한 규칙 밖의 행동을 스스로 학습하지 않음 | 일반 NPC 이동 |
| Raycast 기반 조향 | 예측 가능, 디버깅이 쉬움 | 복잡한 우선순위 규칙이 늘어날 수 있음 | 단순 회피, 보스 패턴 |
| ML-Agents PPO | 목표·위험·거리 규칙을 함께 최적화 | 학습 환경과 보상 설계가 필요함 | 동적 전장, 행동 실험 |
강화학습을 도입해도 모든 이동을 대체할 필요는 없다. 대규모 몬스터 군집은 NavMeshAgent를 기본 이동으로 두고 소수의 특수 몬스터에만 ML-Agents 정책을 적용하는 구성이 비용과 디버깅 측면에서 현실적이다.
몬스터 관측과 행동 공간은 어떻게 설계할까?
Step 1. 관측값을 월드 좌표 대신 로컬 좌표로 정규화한다
정책은 맵의 절대 좌표가 아니라 몬스터 기준의 상대적 상황을 학습해야 한다. 목표까지의 방향은 InverseTransformDirection으로 로컬 좌표로 변환하고 거리는 최대 감지 거리로 나누어 0~1 부근으로 정규화한다.
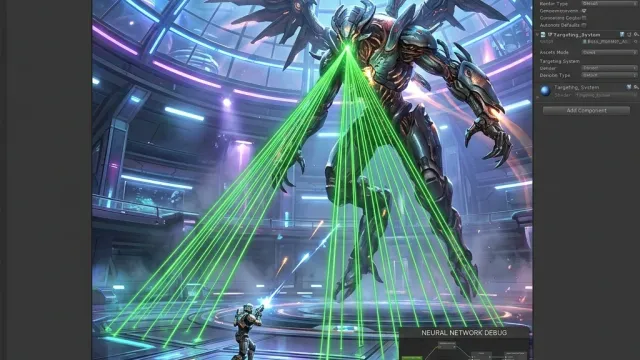
장애물은 전방과 좌우 여러 방향으로 Raycast를 발사해 감지 거리를 제공한다. 감지하지 못했을 때는 1, 가까운 장애물일수록 0에 가까운 값을 기록한다.
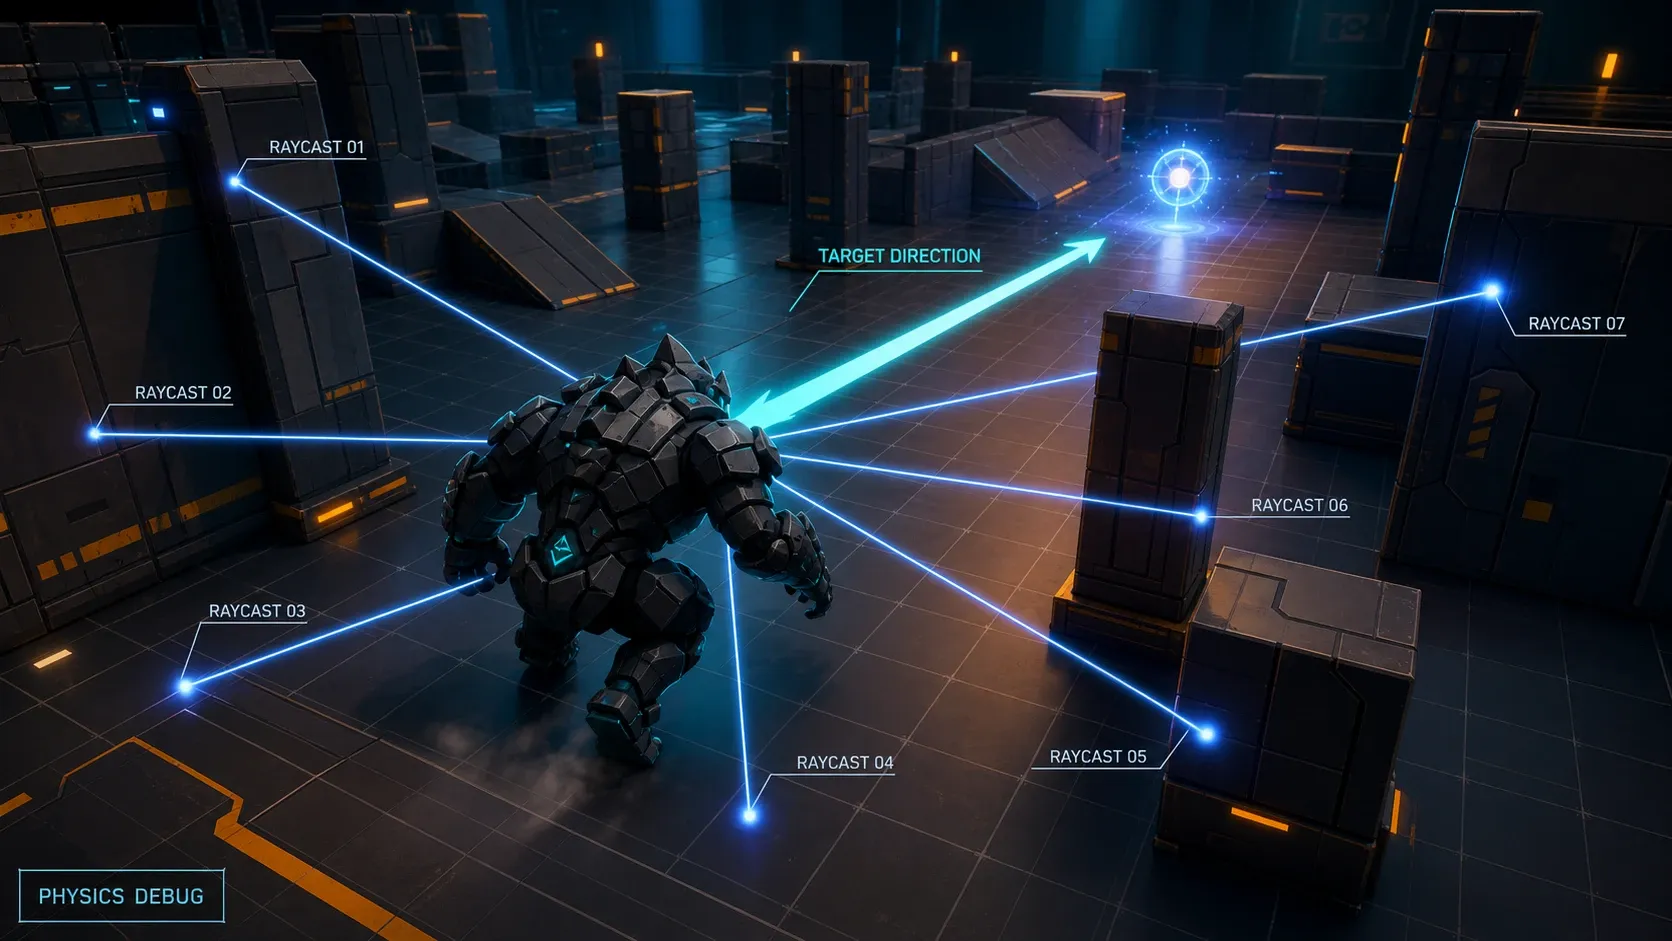
권장 시작 구성은 다음과 같다.
| 항목 | 예시 값 | 목적 |
|---|---|---|
| 목표 방향 | 로컬 X, Z 2개 | 어느 쪽으로 회전할지 판단 |
| 목표 거리 | 1개 | 접근 완료와 우회 필요성 판단 |
| 장애물 Raycast | 5~9개 | 전방·측면 충돌 위험 감지 |
| 평면 속도 | 로컬 X, Z 2개 | 관성 및 정체 상태 판단 |
| 연속 행동 | 전진, 회전 2개 | 자연스러운 이동 제어 |
관측 차원이 바뀌면 이전 체크포인트는 같은 정책 구조로 재사용할 수 없다. Behavior Parameters의 Vector Observation 크기도 실제 CollectObservations에서 추가하는 값 수와 일치시킨다.
Step 2. 연속 행동으로 전진과 회전을 분리한다
행동은 [-1, 1] 범위의 연속값 두 개를 사용한다.
전진은 transform.forward 방향 속도에 회전은 Y축 각속도에 적용한다. Rigidbody를 쓰는 환경에서는 transform.position을 직접 바꾸기보다 Rigidbody.MovePosition, Rigidbody.MoveRotation을 사용해 충돌 판정을 일관되게 유지한다.
using Unity.MLAgents;
using Unity.MLAgents.Actuators;
using Unity.MLAgents.Sensors;
using UnityEngine;

[RequireComponent(typeof(Rigidbody))]
public class MonsterMoveAgent : Agent
{
    [SerializeField] Transform target;
    [SerializeField] float moveSpeed = 4f;
    [SerializeField] float turnSpeed = 180f;
    [SerializeField] float sensorLength = 6f;
    [SerializeField] LayerMask obstacleMask;

    readonly float[] rayAngles = { -75f, -40f, 0f, 40f, 75f };
    Rigidbody body;
    Vector3 spawnPosition;

    public override void Initialize()
    {
        body = GetComponent<Rigidbody>();
        spawnPosition = transform.position;
    }

    public override void OnEpisodeBegin()
    {
        body.linearVelocity = Vector3.zero;
        body.angularVelocity = Vector3.zero;
        transform.SetPositionAndRotation(spawnPosition, Quaternion.identity);
        target.localPosition = new Vector3(
            Random.Range(-8f, 8f), 0.5f, Random.Range(-8f, 8f));
    }

    public override void CollectObservations(VectorSensor sensor)
    {
        Vector3 toTarget = target.position - transform.position;
        Vector3 localDirection = transform.InverseTransformDirection(toTarget.normalized);
        sensor.AddObservation(localDirection.x);
        sensor.AddObservation(localDirection.z);
        sensor.AddObservation(Mathf.Clamp01(toTarget.magnitude / 15f));

        foreach (float angle in rayAngles)
        {
            Vector3 direction = Quaternion.Euler(0f, angle, 0f) * transform.forward;
            bool hit = Physics.Raycast(
                transform.position + Vector3.up * 0.4f,
                direction,
                out RaycastHit hitInfo,
                sensorLength,
                obstacleMask);

            sensor.AddObservation(hit ? hitInfo.distance / sensorLength : 1f);
        }

        Vector3 localVelocity = transform.InverseTransformDirection(body.linearVelocity);
        sensor.AddObservation(localVelocity.x / moveSpeed);
        sensor.AddObservation(localVelocity.z / moveSpeed);
    }

    public override void OnActionReceived(ActionBuffers actions)
    {
        float forward = Mathf.Clamp(actions.ContinuousActions[0], -1f, 1f);
        float turn = Mathf.Clamp(actions.ContinuousActions[1], -1f, 1f);

        Quaternion rotation = body.rotation * Quaternion.Euler(0f, turn * turnSpeed * Time.fixedDeltaTime, 0f);
        body.MoveRotation(rotation);
        body.MovePosition(body.position + transform.forward * (forward * moveSpeed * Time.fixedDeltaTime));

        float distanceBefore = Vector3.Distance(body.position, target.position);
        AddReward(-0.001f);

        if (distanceBefore < 1.2f)
        {
            AddReward(1f);
            EndEpisode();
        }
    }

    void OnCollisionEnter(Collision collision)
    {
        if (((1 << collision.gameObject.layer) & obstacleMask.value) != 0)
        {
            AddReward(-1f);
            EndEpisode();
        }
    }
}Rigidbody.linearVelocity는 사용하는 Unity 버전에 따라 velocity일 수 있다. 프로젝트 API에 맞는 속성으로 교체한다.
장애물 회피 보상은 어떻게 설계해야 할까?
보상은 목표 도달만 크게 주면 된다. 다만 희소 보상만 사용하면 학습 초기에 목표에 닿는 경험이 거의 없어 정책이 개선되지 않는다. 이전 프레임과 현재 프레임의 목표 거리를 비교해 접근 보상을 추가한다.
여기서 k는 보통 0.01~0.1 범위에서 시작한다. 맵 크기와 에피소드 길이에 따라 조정해야 하며 한 단계에서 너무 큰 보상이 발생하지 않도록 제한한다.
float previousDistance;

public override void OnEpisodeBegin()
{
    // 위치 초기화 뒤에 호출한다.
    previousDistance = Vector3.Distance(transform.position, target.position);
}

void RewardProgress()
{
    float currentDistance = Vector3.Distance(transform.position, target.position);
    AddReward((previousDistance - currentDistance) * 0.05f);
    previousDistance = currentDistance;
}| 이벤트 | 시작 보상 예시 | 의도 |
|---|---|---|
| 목표 도달 | +1.0 | 에피소드의 명확한 성공 조건 |
| 목표에 접근 | 거리 변화량 × 0.05 | 탐색 초기에 학습 신호 제공 |
| 장애물 충돌 | -1.0 후 종료 | 위험 행동 제거 |
| 매 스텝 | -0.001 | 불필요한 배회 억제 |
| 맵 이탈 | -1.0 후 종료 | 학습 영역 유지 |
충돌 패널티가 목표 보상보다 지나치게 크면 몬스터가 움직이지 않는 정책으로 수렴할 수 있다. 반대로 시간 패널티가 너무 크면 장애물 앞에서 무리하게 돌진한다. TensorBoard에서 episode reward, episode length, 성공률을 함께 보고 값을 조절한다.
flowchart TD
    A[에피소드 시작] --> B[목표와 장애물 위치 무작위화]
    B --> C[목표·Raycast·속도 관측]
    C --> D[PPO 정책이 전진·회전 행동 출력]
    D --> E{목표 도달?}
    E -- 예 --> F[보상 +1, 에피소드 종료]
    E -- 아니오 --> G{장애물 충돌 또는 맵 이탈?}
    G -- 예 --> H[패널티 -1, 에피소드 종료]
    G -- 아니오 --> I[접근 보상과 시간 패널티]
    I --> C
PPO 학습 환경은 어떻게 구성할까?
Step 3. 쉬운 맵에서 시작해 난이도를 높인다
처음부터 복잡한 미로와 다수의 움직이는 장애물을 넣으면 탐색 공간이 급격히 커진다. 다음 순서로 커리큘럼을 구성한다.
- 장애물 없는 평면에서 목표 추적만 학습한다.
- 큰 정적 장애물 1~2개를 추가해 Raycast와 충돌 패널티를 검증한다.
- 장애물 수, 배치 범위, 목표 위치를 무작위화한다.
- 움직이는 장애물과 공격 사거리 같은 실제 게임 규칙을 추가한다.
Behavior Parameters에서는 Continuous Actions를 2로 설정하고 학습 중에는 Default Behavior Type을 Default로 둔다. Heuristic 테스트가 필요하면 Heuristic Only로 바꾸고 키보드 입력이나 임시 조향 로직을 구현한다.
behaviors:
  MonsterObstacleAvoidance:
    trainer_type: ppo
    hyperparameters:
      batch_size: 1024
      buffer_size: 10240
      learning_rate: 0.0003
      beta: 0.005
      epsilon: 0.2
      lambd: 0.95
      num_epoch: 3
    network_settings:
      normalize: true
      hidden_units: 128
      num_layers: 2
    reward_signals:
      extrinsic:
        gamma: 0.99
        strength: 1.0
    max_steps: 1000000
    time_horizon: 64
    summary_freq: 10000
학습 중에는 장애물과 목표 위치를 매 에피소드마다 바꾸되 시작 위치가 장애물 내부나 목표 반경 안에 생성되지 않도록 별도의 유효성 검사를 둔다. 또한 학습용 Physics 설정과 실제 게임의 이동 속도·콜라이더 크기를 최대한 맞춰야 배포 시 행동이 크게 달라지지 않는다.
학습한 Monster AI가 움직이지 않거나 벽에 부딪히는 이유는?
다음 항목을 먼저 확인하면 대부분의 문제를 빠르게 찾을 수 있다.
- 관측 개수와
Behavior Parameters의 Vector Observation 크기가 일치하는지 확인한다. - Raycast의
LayerMask가 실제 장애물 레이어를 포함하는지 확인한다. FixedUpdate기반 물리 이동과OnActionReceived의 시간 단위가 일관적인지 확인한다.- 목표 도달 판정이 콜라이더 크기와 이동 속도에 비해 너무 작은지 확인한다.
- 충돌 후
EndEpisode()를 호출해 실패 경험이 다음 에피소드로 섞이지 않게 한다. - 관측값의 범위가 과도하게 크지 않은지 확인한다. 거리와 속도는 가능한 한 정규화한다.
자주 묻는 질문 (FAQ)
ML-Agents와 NavMeshAgent를 함께 사용해도 되나?
가능하다. 다만 같은 프레임에 두 시스템이 Transform 또는 Rigidbody를 동시에 제어하면 충돌한다. ML-Agents가 조향만 출력하고 NavMeshAgent가 이동을 담당하도록 역할을 분리하거나 상황별로 한쪽만 활성화한다.
Raycast는 몇 개부터 시작하는 것이 좋은가?
전방, 좌전방, 우전방을 포함한 5개가 최소 시작점으로 적합하다. 좁은 통로나 빠른 이동이 많은 게임은 7~9개로 늘리되 관측 차원이 커질수록 학습 시간을 다시 측정한다.
학습한 ONNX 모델은 어떻게 게임에 적용하나?
학습 결과의 .onnx 파일을 Unity 프로젝트에 넣고 Behavior Parameters의 Model 슬롯에 연결한다. 배포 빌드에서는 Behavior Type을 Inference Only로 설정해 Python 학습 프로세스 없이 Barracuda/Sentis 추론 경로로 실행한다.
정리
ML-Agents 기반 장애물 회피의 핵심은 복잡한 네트워크가 아니라 관측과 보상 설계다. 몬스터 로컬 기준의 목표 정보, 다방향 장애물 거리, 전진·회전 연속 행동을 먼저 안정화한 뒤 단계적으로 전장 규칙을 추가하면 재현성과 디버깅 가능성을 유지하면서 지능형 이동을 확장할 수 있다.