카드 게임 덱 다양성 지수(Deck Diversity) 측정: 메타 덱 AI 자동 분석 설계
카드 게임 메타 덱을 자동 수집·정규화·클러스터링하고 엔트로피, 심슨 지수, 덱 리스트 유사도로 Deck Diversity Index를 계산하는 실전 설계를 정리합니다. 패치 전후 비교와 밸런스 의사결정에 활용하는 방법까지 다룹니다.
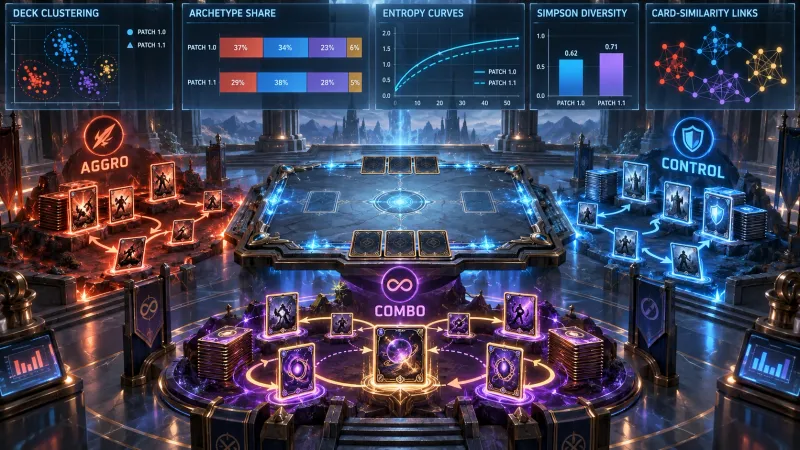
핵심 요약
카드 게임의 덱 다양성은 덱 개수만 세는 방식보다 메타 점유율과 카드 구성의 차이를 함께 측정해야 합니다. 덱 데이터를 정규화한 뒤 카드 벡터를 클러스터링하고 정규화 엔트로피·심슨 다양성 지수·멀티셋 자카드 거리로 Deck Diversity Index를 계산하면 패치 전후의 메타 집중도를 비교할 수 있습니다.
AI는 원천 데이터 판정과 지수 계산을 대신하기보다 덱 유형 이름 지정, 변화 원인 요약, 밸런스 리포트 생성에 사용하는 것이 안전합니다.
카드 게임 덱 다양성은 왜 단순한 덱 개수로 측정하기 어려운가?
메타에 20개의 덱 리스트가 존재해도 실제 승률과 플레이 비중이 한 덱에 몰려 있다면 플레이어가 체감하는 선택지는 좁습니다. 반대로 덱 리스트 수는 적어도 핵심 카드와 운영 방식이 크게 다르면 전략적 다양성은 높을 수 있습니다.
따라서 자동 분석 시스템은 최소한 다음 세 가지를 구분해야 합니다.
| 측정 대상 | 의미 | 한계 |
|---|---|---|
| 덱 리스트 수 | 등록된 고유 덱 조합의 개수 | 변형 덱을 과대평가하기 쉬움 |
| 아키타입 점유율 | 어그로, 컨트롤, 콤보 등 전략 유형별 비중 | 같은 아키타입 안의 차이를 놓침 |
| 카드 구성 거리 | 두 덱의 카드 수량이 얼마나 다른지 | 카드 효과와 운영 난이도는 직접 설명하지 못함 |
실무에서는 세 지표를 별도로 저장한 뒤 하나의 종합 지수인 DDI로 결합하는 편이 좋습니다. 종합 점수 하나만 남기면 점수가 낮아진 원인이 아키타입 쏠림인지 카드 구성의 획일화인지 알기 어렵기 때문입니다.
메타 덱 AI 자동 분석의 전체 구조는 어떻게 설계할까?
AI 자동 분석은 다음 순서로 구성합니다.
- 게임 클라이언트, 리플레이 서버, 대회 결과 또는 덱 공유 서비스에서 덱 스냅샷을 수집합니다.
- 카드 ID와 패치 버전을 기준으로 덱 리스트를 정규화합니다.
- 카드 수량 벡터를 만들고 유사한 덱을 클러스터링합니다.
- 클러스터별 점유율과 덱 간 거리를 계산합니다.
- 통계적으로 유의한 변화만 골라 AI가 원인과 대응안을 요약합니다.
핵심은 LLM이 점수를 임의로 판단하지 않게 만드는 것입니다. 지수 계산은 재현 가능한 코드로 처리하고 AI는 설명 계층에 배치해야 밸런스 회의에서 근거를 추적할 수 있습니다.
덱 데이터 정규화에서 반드시 고정해야 하는 규칙
덱 정규화가 흔들리면 같은 덱이 서로 다른 덱으로 집계됩니다. 다음 필드를 원천 데이터에 함께 저장하는 것을 권장합니다.
| 필드 | 처리 규칙 |
|---|---|
canonical_card_id | 일러스트, 언어, 스킨이 달라도 같은 카드로 통합 |
quantity | 카드 수량을 보존하고 정렬 순서는 무시 |
main_deck와 sideboard | 게임 규칙에 따라 분리 저장 |
patch_id | 밸런스 패치가 다른 데이터는 같은 집계에 섞지 않음 |
player_id | 특정 헤비 플레이어의 반복 게임 가중치를 관리 |
timestamp | 패치 직후와 안정화 이후를 분리 비교 |
unknown_card | 카드 ID를 찾지 못한 덱은 격리하고 분석에서 제외하거나 별도 표시 |
특히 카드 수량을 버리고 카드의 존재 여부만 비교하면 1장 테크 카드와 4장 핵심 카드가 동일하게 취급됩니다. 덱 리스트 거리를 계산할 때는 카드 수량을 유지하는 멀티셋 표현이 더 적합합니다.
덱 아키타입은 AI로 어떻게 자동 분류할까?
각 덱을 카드별 수량 벡터로 변환합니다. 카드 풀이 M개이고 덱 d의 카드 c 수량이 n_dc라면 덱 벡터는 다음과 같습니다.
카드 수가 많은 덱이 거리를 지배하지 않도록 전체 카드 수로 나누거나 TF-IDF 가중치를 적용할 수 있습니다. 카드 게임에서는 다음 조합이 실용적입니다.
- 기본 벡터: 카드 수량을 전체 덱 크기로 나눈 정규화 빈도
- 거리 함수: 코사인 거리 또는 멀티셋 자카드 거리
- 클러스터링: 사전에 아키타입 수를 알기 어렵다면 HDBSCAN
- 최소 클러스터 조건: 표본 수와 메타 점유율 기준을 모두 적용
- 재분류 주기: 새 패치 후 즉시 한 번, 데이터 안정화 후 다시 한 번
HDBSCAN에서 생성된 클러스터를 곧바로 게임 내 아키타입 이름으로 사용하지는 않습니다. 클러스터 안에서 점유율이 높은 카드, 승리 조건 카드, 평균 비용, 주요 색상이나 진영을 추출한 다음 저비용 하수인 중심 어그로, 광역기 기반 컨트롤처럼 규칙 기반 템플릿을 먼저 적용합니다. 템플릿으로 설명하기 어려운 경우에만 LLM을 사용해 이름과 요약 문장을 생성합니다.
아키타입 클러스터가 안정적인지 어떻게 검증할까?
클러스터 수가 많다고 분석 품질이 좋아지는 것은 아닙니다. 다음 검증을 함께 사용합니다.
- 실루엣 계수: 같은 클러스터 내부와 다른 클러스터 사이의 거리 비교
- 시간 안정성: 날짜 구간을 바꿔도 비슷한 클러스터가 유지되는지 확인
- 패치 안정성: 카드 밸런스 변경이 없는 기간에 아키타입이 불필요하게 분리되지 않는지 확인
- 전문가 샘플 검수: 각 클러스터에서 점유율 상위 덱을 직접 확인
- 노이즈 비율: HDBSCAN이 어느 정도의 덱을 노이즈로 분류하는지 기록
클러스터가 매일 크게 바뀐다면 모델보다 입력 데이터의 표본 수, 덱 정규화, 패치 분리 조건을 먼저 점검해야 합니다.
Deck Diversity Index는 어떤 수식으로 계산할까?
아키타입 분포를 p_a라고 하겠습니다. p_a는 전체 가중치 중 아키타입 a가 차지하는 비중이며 다음과 같이 계산합니다.
여기서 w_d는 덱이 관측된 경기 수, 고유 플레이어 수, 대회 라운드 가중치 등 분석 목적에 맞는 가중치입니다. 랭크 게임에서는 한 플레이어가 지나치게 많은 게임을 기록해 결과를 왜곡하지 않도록 플레이어별 일일 경기 수를 제한하거나 플레이어 단위 가중치를 적용할 수 있습니다.
1. 정규화 엔트로피
아키타입 분포가 여러 유형에 고르게 퍼져 있는지를 측정합니다.
K는 관측된 아키타입 수입니다. 한 아키타입이 전체를 차지하면 0에 가까워지고 모든 아키타입의 비중이 같으면 1에 가까워집니다. 표본이 적은 클러스터가 많을 때는 최소 점유율 조건을 두거나 베이지안 스무딩을 적용해야 합니다.
2. 심슨 다양성 지수
상위 아키타입 쏠림을 빠르게 감지하려면 심슨 다양성 지수를 함께 봅니다.
엔트로피가 전체 분포의 불확실성을 보여준다면 심슨 지수는 무작위로 두 덱을 선택했을 때 서로 다른 아키타입일 가능성을 직관적으로 보여줍니다.
3. 덱 리스트 고유성
두 덱의 카드 구성을 비교할 때는 수량을 반영한 멀티셋 자카드 유사도를 사용할 수 있습니다.
덱 리스트 고유성 U는 가중 평균 유사도의 반대값으로 계산합니다.
U가 1에 가까울수록 카드 구성이 서로 다릅니다. 덱 수가 많을 때 모든 쌍을 비교하면 계산량이 커지므로 표본 추출, 최근접 이웃 탐색, 클러스터 내부 대표 덱 비교로 줄일 수 있습니다.
4. 종합 DDI
세 지표를 다음처럼 결합할 수 있습니다.
가중치는 게임의 목표에 따라 정합니다. 전략 선택지를 중요하게 보면 H_norm과 D_Simpson의 비중을 높이고 덱 구축의 창의성과 카드 사용 폭을 중요하게 보면 U의 비중을 높입니다. 초기값을 정한 뒤 고정된 역사적 시즌 데이터로 검증하고 특정 점수가 실제 플레이어의 선택 다양성과 일치하는지 확인해야 합니다.
DDI 계산은 어떻게 구현할까?
다음은 Python 3.12 기준의 간단한 계산 예시입니다. 아키타입 분류 결과와 덱 카드 수량이 이미 정규화되어 있다는 전제입니다.
from collections import Counter
from math import log


def multiset_jaccard(left: dict[str, int], right: dict[str, int]) -> float:
    cards = set(left) | set(right)
    intersection = sum(min(left.get(card, 0), right.get(card, 0)) for card in cards)
    union = sum(max(left.get(card, 0), right.get(card, 0)) for card in cards)
    return intersection / union if union else 0.0


def list_uniqueness(
    deck_cards: dict[str, dict[str, int]],
    weights: dict[str, float],
) -> float:
    deck_ids = list(deck_cards)
    weighted_similarity = 0.0
    weight_sum = 0.0

    for index, left_id in enumerate(deck_ids):
        for right_id in deck_ids[index + 1:]:
            pair_weight = weights[left_id] * weights[right_id]
            weighted_similarity += pair_weight * multiset_jaccard(
                deck_cards[left_id], deck_cards[right_id]
            )
            weight_sum += pair_weight

    return 1.0 - weighted_similarity / weight_sum if weight_sum else 0.0


def deck_diversity_index(
    archetypes: dict[str, str],
    deck_cards: dict[str, dict[str, int]],
    weights: dict[str, float],
    alpha: float = 0.4,
    beta: float = 0.3,
    gamma: float = 0.3,
) -> dict[str, float]:
    total_weight = sum(weights.values())
    distribution = Counter()

    for deck_id, archetype in archetypes.items():
        distribution[archetype] += weights[deck_id] / total_weight

    archetype_count = len(distribution)
    entropy = -sum(
        share * log(share)
        for share in distribution.values()
        if share > 0
    )
    normalized_entropy = (
        entropy / log(archetype_count)
        if archetype_count > 1
        else 0.0
    )
    simpson = 1.0 - sum(share ** 2 for share in distribution.values())
    uniqueness = list_uniqueness(deck_cards, weights)
    ddi = alpha * normalized_entropy + beta * simpson + gamma * uniqueness

    return {
        'normalized_entropy': normalized_entropy,
        'simpson_diversity': simpson,
        'list_uniqueness': uniqueness,
        'ddi': ddi,
    }
이 코드는 덱 리스트 단위로 고유성을 계산합니다. 데이터가 경기 단위로 저장되어 있다면 같은 덱 리스트를 먼저 묶고 weights에 경기 수나 플레이어 보정 가중치를 넣어야 합니다.
메타 분석 결과를 밸런싱 의사결정에 연결하는 3단계
1단계: 기준선과 비교한다
DDI 절대값만 보고 0.6이면 건강한 메타라고 단정하면 안 됩니다. 게임마다 카드 풀, 덱 크기, 진영 수, 경쟁 모드가 다르기 때문입니다.
시즌별 또는 패치별로 다음 기준선을 저장합니다.
- 최근 4~8개 안정 패치의 DDI 평균과 표준편차
- 상위 1개와 상위 3개 아키타입 점유율
- 평균 덱 리스트 간 유사도
- 새 카드 사용률과 승률 변화
- 플레이어별 고유 덱 수
그다음 현재 패치의 변화량과 롤링 기준선의 z-score를 함께 확인합니다. DDI가 낮아졌다는 사실보다 어떤 구성 요소가 얼마나 변했는지가 더 중요합니다.
2단계: 원인을 분해한다
DDI 하락은 서로 다른 문제에서 발생할 수 있습니다.
| 관측 결과 | 가능성이 높은 원인 | 우선 점검할 항목 |
|---|---|---|
| 엔트로피와 심슨 지수가 함께 하락 | 특정 아키타입 쏠림 | 핵심 카드, 승률, 매치업 상성 |
아키타입 지수는 유지되고 U만 하락 | 같은 덱의 획일적 복제 | 자동 포함 카드, 범용 카드 효율 |
U는 높지만 승률 편차가 큼 | 다양한 비주류 덱과 한두 개의 지배 덱 공존 | 표본 수 보정, 상위 백분위 승률 |
| 클러스터 수가 갑자기 증가 | 카드 1~2장 차이의 과도한 분리 | 거리 임계값, 최소 클러스터 크기 |
| DDI는 높지만 신규 유저 이탈 증가 | 다양성은 높지만 학습 비용도 높음 | 덱 제작 비용, 튜토리얼, 매치메이킹 |
이 분해가 있어야 밸런스 패치가 단순한 너프 목록이 아니라 문제 원인에 대한 처방이 됩니다.
3단계: 패치 시뮬레이션과 사후 검증을 수행한다
패치 후보 카드의 효과를 바꾼 뒤 과거 매치업 모델이나 게임 시뮬레이터로 예상 덱 분포를 계산합니다. 이후 실제 패치 데이터가 쌓이면 예측과 관측을 비교합니다.
AI 리포트에는 다음 정보를 함께 표시하는 것이 좋습니다.
- 현재 DDI와 기준선 대비 변화량
- 점수 하락에 기여한 아키타입
- 새로 등장하거나 사라진 카드 조합
- 신뢰구간 또는 부트스트랩 범위
- 추천 조치와 추천 조치가 실패할 수 있는 조건
AI 자동 분석에서 LLM은 어디까지 사용해야 할까?
LLM은 정량 지표를 대체하는 모델이 아니라 분석 결과를 사람이 읽을 수 있는 게임 디자인 언어로 변환하는 도구로 두는 편이 안전합니다.
권장 입력은 다음과 같습니다.
{
  "patch_id": "1.8.0",
  "ddi": 0.42,
  "baseline_ddi": 0.57,
  "top_archetypes": [
    {"name": "저비용 어그로", "share": 0.48, "win_rate": 0.56},
    {"name": "광역 컨트롤", "share": 0.22, "win_rate": 0.51}
  ],
  "changed_cards": ["card_1024", "card_2048"],
  "confidence_interval": [0.39, 0.45]
}
프롬프트에는 입력된 수치만 사용하고 새로운 승률을 추정하지 말 것, 인과관계가 확인되지 않은 경우 상관관계로 표현할 것, 추천 변경안에는 예상되는 부작용을 함께 쓸 것 같은 제약을 포함합니다.
반대로 다음 작업을 LLM 단독으로 맡기면 안 됩니다.
- 덱 아키타입의 최종 분류
- 승률과 인과관계의 확정
- 표본 수가 적은 덱의 밸런스 판단
- 유저 경제에 영향을 주는 보상 및 제작 비용 변경
- 패치 전후 데이터의 직접 병합
분류 결과에는 항상 cluster_id, sample_size, confidence, representative_cards를 함께 저장해 사람이 원인을 역추적할 수 있게 합니다.
분석 결과를 실제 게임 UX에 어떻게 보여줄까?
플레이어에게 내부 지수의 소수점 값을 그대로 노출할 필요는 없습니다. 대신 덱 제작 화면이나 시즌 리포트에서 다음처럼 번역할 수 있습니다.
전략 다양성: 여러 아키타입이 경쟁 중인지 표시덱 개성: 같은 아키타입 안에서도 카드 구성이 다양한지 표시메타 집중 경고: 상위 아키타입 점유율이 기준선을 넘었을 때 표시추천 탐색 덱: 승률이 아니라 현재 부족한 전략 영역을 보완하는 덱 추천
중요한 점은 다양성이 높다고 항상 좋은 경험은 아니라는 사실입니다. 신규 유저에게는 카드 풀이 너무 넓으면 선택 비용이 커질 수 있습니다. 따라서 내부 DDI와 함께 제작 비용, 평균 게임 시간, 학습 난이도, 매치업 가독성을 별도 지표로 관리해야 합니다.
자주 묻는 질문 FAQ
덱 리스트 수와 아키타입 수 중 무엇을 기준으로 삼아야 하나요?
둘 다 필요합니다. 아키타입 수와 점유율은 전략 선택지의 폭을 보여주고 멀티셋 자카드 기반 고유성은 같은 전략 안의 구축 차이를 보여줍니다. 하나의 지표만 사용하면 메타의 일부만 측정하게 됩니다.
카드 한 장이 바뀐 덱을 새로운 아키타입으로 봐야 하나요?
보통은 아닙니다. 거리 임계값만으로 분리하지 말고 최소 점유율, 일정 기간의 지속성, 승리 조건의 차이를 함께 확인해야 합니다. 카드 한 장의 변경이 운영 방식과 매치업을 실제로 바꿀 때만 별도 아키타입으로 승격하는 것이 적절합니다.
표본이 적은 덱의 높은 승률은 어떻게 처리하나요?
최소 경기 수 조건을 두고 신뢰구간을 계산해야 합니다. 플레이어 단위 부트스트랩이나 베타-이항 모델을 사용하면 소표본 덱의 승률이 과대평가되는 문제를 줄일 수 있습니다.
정리
카드 게임의 Deck Diversity는 고유 덱 개수를 세는 기능이 아니라 메타 선택지의 분포와 덱 구성의 차이를 측정하는 분석 체계입니다. 덱 데이터를 패치 단위로 정규화하고 HDBSCAN 같은 클러스터링으로 아키타입을 추출한 뒤 정규화 엔트로피, 심슨 지수, 멀티셋 자카드 기반 고유성을 결합하면 패치 전후 메타 변화를 재현 가능하게 비교할 수 있습니다.
가장 안정적인 운영 방식은 정량 계산을 코드로 고정하고 LLM은 설명과 탐색 보조에 사용하는 것입니다. 이렇게 하면 밸런스 팀은 다양성이 낮다는 결론에 머물지 않고 어떤 아키타입과 카드 조합이 메타를 좁혔는지 확인한 뒤 패치와 UX 개선을 함께 설계할 수 있습니다.