방치형 게임 재화 인플레이션 시뮬레이션: 시간당 골드 수급량 AI 자동 피팅 방법
방치형 게임의 시간당 골드 수급량을 로그 데이터로 측정하고 Python·SciPy 기반 자동 피팅으로 성장 곡선과 인플레이션 시점을 예측하는 실전 밸런싱 방법을 정리합니다. 오프라인 보상, 퀘스트, 광고 보너스까지 함께 모델링합니다.
핵심 요약
방치형 게임의 재화 인플레이션은 시간당 골드 수급량이 강화 비용이나 소비처의 증가 속도보다 빠를 때 발생합니다. Python 3.12, Pandas, NumPy, SciPy의 least_squares를 사용하면 실제 로그에서 골드 수급 곡선을 자동 피팅하고 미래 구간의 경제 상태를 시뮬레이션할 수 있습니다. 여기서 AI 자동 피팅은 생성형 AI가 임의의 숫자를 만드는 방식이 아니라 로그 데이터에 가장 잘 맞는 파라미터를 최적화하는 데이터 기반 추정 과정입니다.
방치형 게임 재화 인플레이션은 왜 발생하는가?
방치형 게임의 경제는 크게 재화 유입과 재화 소모로 나눌 수 있습니다.
여기서 는 플레이어가 특정 진행 시점 에서 한 시간 동안 얻는 골드입니다. 강화, 장비 구매, 스테이지 입장료 등으로 소비되는 양은 다음처럼 별도의 함수로 둡니다.
순자산 변화량은 다음과 같이 계산할 수 있습니다.
대체로 인 구간에서는 플레이어의 보유 골드가 계속 쌓입니다. 신규 강화 비용이 충분히 빠르게 증가하지 않으면 골드가 더 이상 의사결정의 제약 조건이 되지 않습니다. 이 상태가 재화 인플레이션입니다.
핵심 판단 지표는 수급량과 소비량의 비율입니다.
- : 하루 동안 보유 재화가 감소하는 구간
- : 수급과 소비가 균형을 이루는 구간
- : 소비 후에도 재화가 축적되는 구간
시간당 골드 수급량 자동 피팅에는 어떤 로그가 필요한가?
단순히 하루 동안 얻은 골드 총량만 저장하면 광고 시청이나 접속 시간의 영향을 분리하기 어렵습니다. 이벤트 단위 로그를 남기고 계정 진행 시간 또는 스테이지 기준으로 집계해야 합니다.
| 로그 이벤트 | 필수 필드 | 활용 목적 |
|---|---|---|
| 스테이지 보상 | account_id, stage_id, gold, timestamp | 기본 골드 수급 곡선 계산 |
| 퀘스트 보상 | quest_id, gold, timestamp | 일회성·반복성 보상 분리 |
| 광고 보상 | placement, gold, timestamp | 광고 보너스 의존도 분석 |
| 오프라인 보상 | offline_seconds, gold, cap_seconds | 오프라인 보상 상한 검증 |
| 강화 소비 | upgrade_id, gold, timestamp | 골드 싱크 곡선 계산 |
| 보유 잔액 | balance_before, balance_after | 순자산 변화 검산 |
시간당 수급량은 달력 기준보다 실제 계정 진행 시간 기준으로 계산하는 편이 안정적입니다. 예를 들어 접속하지 않은 12시간을 모두 플레이 시간으로 처리하면 활성 유저와 휴면 유저의 경제 곡선이 섞입니다.
권장 집계 단위는 다음과 같습니다.
- 계정별로 이벤트를
account_hour또는stage_progress에 매핑합니다. - 같은 구간의 골드 획득량을 합산합니다.
- 계정 수, 활성 시간, 광고 시청 수를 함께 집계합니다.
- 표본 수가 적은 구간은 피팅에서 가중치를 낮추거나 별도 표시합니다.
골드 성장 곡선은 어떤 모델을 선택해야 하는가?
모든 방치형 게임에 하나의 공식이 맞는 것은 아닙니다. 게임의 보상 테이블과 강화 구조에 맞춰 후보 모델을 여러 개 만들고 검증 오차가 낮은 모델을 선택해야 합니다.
| 모델 | 수식 | 적합한 상황 | 주의점 |
|---|---|---|---|
| 선형 | 초반 튜토리얼 구간 | 후반 폭증을 설명하기 어려움 | |
| 거듭제곱 | 스테이지가 점진적으로 증가하는 구조 | 가 커지면 후반 인플레이션이 빠름 | |
| 지수 | 배율형 보상과 승급 시스템 | 작은 오차가 후반에 크게 확대됨 | |
| 로그 | 성장 둔화형 보상 | 후반 수급 상한을 표현하기 어려움 | |
| 구간별 모델 | 구간마다 다른 함수 적용 | 챕터·전직·환생이 있는 게임 | 구간 경계에서 불연속이 생길 수 있음 |
실무에서는 스테이지 보상에 거듭제곱 모델을 적용하고 퀘스트와 오프라인 보상은 별도 항으로 분리하는 방식이 다루기 쉽습니다.
Python과 SciPy로 시간당 골드 수급량을 자동 피팅하는 방법
아래 예시는 gold_hourly.csv에 다음 컬럼이 있다고 가정합니다.
account_hour: 설치 후 계정 진행 시간gold_per_hour: 해당 구간의 시간당 골드 수급량sample_count: 해당 구간을 만든 계정 수
모델은 스테이지 보상과 퀘스트 보상 그리고 오프라인 보상을 합산합니다.
import numpy as np
import pandas as pd
from scipy.optimize import least_squares


def gold_model(hour, a, b, quest_scale, offline_scale, offline_tau):
    stage_gold = a * np.power(hour + 1.0, b)
    quest_gold = quest_scale * np.log1p(hour)
    offline_gold = offline_scale * (1.0 - np.exp(-hour / offline_tau))
    return stage_gold + quest_gold + offline_gold


df = pd.read_csv('gold_hourly.csv')
df = df.query('account_hour >= 0 and gold_per_hour >= 0').copy()
df = df.dropna(subset=['account_hour', 'gold_per_hour', 'sample_count'])

after_install_hour = df['account_hour'].to_numpy(dtype=float)
observed_gold = df['gold_per_hour'].to_numpy(dtype=float)
sample_count = np.maximum(df['sample_count'].to_numpy(dtype=float), 1.0)


def residual(params):
    predicted = gold_model(after_install_hour, *params)
    normalized_error = (predicted - observed_gold) / np.maximum(observed_gold, 1.0)
    return normalized_error * np.sqrt(sample_count)


initial_params = [100.0, 1.0, 20.0, 50.0, 24.0]
lower_bounds = [0.0, 0.0, 0.0, 0.0, 1.0]
upper_bounds = [1_000_000.0, 5.0, 1_000_000.0, 1_000_000.0, 720.0]

result = least_squares(
    residual,
    x0=initial_params,
    bounds=(lower_bounds, upper_bounds),
    loss='soft_l1',
    f_scale=0.15,
    max_nfev=20_000,
)

fitted_params = result.x
future_hour = np.arange(0.0, 721.0)
future_gold = gold_model(future_hour, *fitted_params)

df['predicted_gold'] = gold_model(after_install_hour, *fitted_params)
df['residual'] = df['gold_per_hour'] - df['predicted_gold']
rmse = np.sqrt(np.mean(np.square(df['residual'])))

print('fitted_params:', fitted_params)
print('rmse:', rmse)
print('success:', result.success)loss='soft_l1'은 특정 이벤트나 비정상적으로 큰 광고 보상 때문에 일부 로그가 튀는 상황에서 유용합니다. 모든 데이터를 동일하게 취급하지 않고 sample_count를 가중치로 사용했기 때문에 표본이 많은 구간의 추정값이 더 안정적으로 반영됩니다.
다만 이 결과를 곧바로 밸런스 테이블에 적용해서는 안 됩니다. 피팅 결과는 현재 데이터의 평균적인 경향을 설명하는 모델이며 플레이어의 목표값이 아닙니다. 최소한 학습 구간과 검증 구간을 나누고 다음 지표를 함께 확인해야 합니다.
초반 수급량이 매우 작으면 MAPE가 과도하게 커질 수 있고 관측값이 0이면 정의되지 않습니다. 0인 관측값을 어떻게 처리할지 사전에 정하고 RMSE와 중앙 절대 오차도 함께 보는 편이 좋습니다.
피팅 결과를 재화 인플레이션 시뮬레이션으로 연결하기
자동 피팅의 목적은 그래프를 예쁘게 그리는 것이 아니라 미래의 경제 상태를 예측하는 것입니다. 다음 순서로 사용하면 됩니다.
1단계: 골드 유입과 골드 소비를 분리한다
골드 수급 곡선만 피팅하면 인플레이션 여부를 판단할 수 없습니다. 같은 방식으로 강화 비용과 상점 구매량을 집계해 소비 곡선을 만듭니다.
여기서 는 하루 평균 유효 플레이 시간입니다. 활성 플레이 시간당 수급·소비량과 하루 오프라인 보상을 분리해 집계해야 단위가 맞습니다.
2단계: 플레이어 세그먼트를 나눠서 피팅한다
전체 유저 평균만 사용하면 서로 다른 경제 상태가 희석됩니다.
| 세그먼트 | 정의 예시 | 별도 분석 이유 |
|---|---|---|
| 신규 유저 | 설치 후 24시간 이내 | 튜토리얼 보상과 첫 구매 영향이 큼 |
| 활성 유저 | 최근 24시간 내 접속 | 실제 플레이 기반 수급을 측정하기 좋음 |
| 휴면 복귀 유저 | 일정 기간 후 재접속 | 누적 오프라인 보상과 복귀 보너스 영향이 큼 |
| 고과금 유저 | 결제 또는 광고 이용량 상위 그룹 | 추가 배율로 인해 일반 유저와 곡선이 다름 |
세그먼트별로 모델의 파라미터가 크게 다르면 전체 유저에 하나의 골드 수급 공식만 적용해서는 안 됩니다.
3단계: 경제 상태를 시나리오별로 시뮬레이션한다
최소한 다음 세 가지 시나리오를 비교합니다.
- 기준 시나리오: 현재 보상과 비용 유지
- 수급 증가 시나리오: 광고 보너스 또는 스테이지 보상 증가
- 소비 약화 시나리오: 강화 비용 증가율 감소 또는 신규 골드 싱크 부족
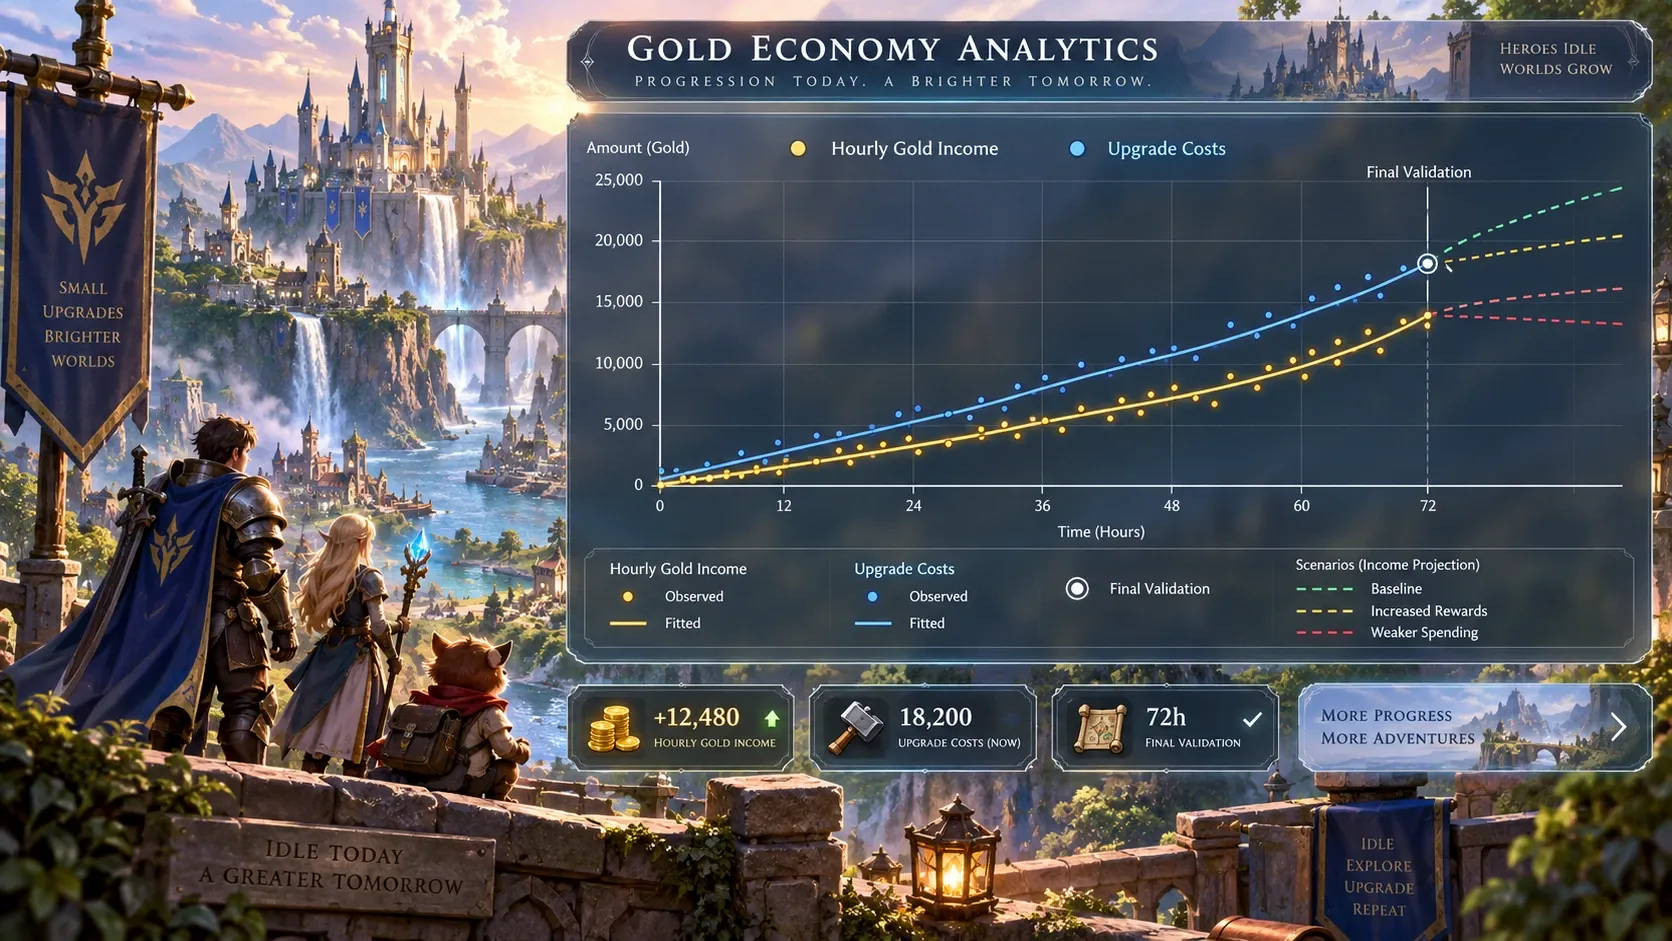
그래프에서는 실제 관측값과 피팅 곡선을 같은 좌표에 표시해야 합니다. 관측값이 없는 후반 구간까지 곡선만 길게 연장하면 모델의 오차가 크게 확대될 수 있으므로 검증 데이터의 마지막 지점도 표시하는 것이 좋습니다.
인플레이션을 줄이는 밸런싱 파라미터는 무엇인가?
수급량을 일괄적으로 낮추는 방법은 빠르지만 플레이어가 이미 익숙해진 보상 감각을 훼손할 수 있습니다. 먼저 어떤 항이 인플레이션을 주도하는지 확인해야 합니다.
| 원인 | 관찰되는 현상 | 조정 후보 |
|---|---|---|
| 스테이지 보상 증가율 과다 | 진행할수록 순자산이 급증 | 보상 지수 조정 |
| 오프라인 보상 상한 과다 | 장시간 미접속 후 잔액 급증 | cap_seconds, 오프라인 배율 조정 |
| 광고 보너스 중첩 | 광고 이용자만 경제가 빠르게 앞섬 | 일일 횟수와 배율 제한 |
| 강화 비용의 성장 정체 | 골드가 소비되지 않고 누적 | 비용 지수 또는 단계별 비용 추가 |
| 골드 싱크 부족 | 고레벨에서 소비할 콘텐츠가 없음 | 재료 제작, 장비 재련, 편의 기능 추가 |
개발 중인 밸런스 테이블에는 피팅값만 저장하지 말고 다음 정보를 함께 저장하는 편이 안전합니다.
- 데이터 수집 기간
- 대상 세그먼트
- 모델 종류
- 파라미터와 신뢰 구간
- 학습·검증 오차
- 적용 가능한 스테이지 범위
- 마지막 수동 검토자와 검토일
특히 AI가 추천한 파라미터를 운영 서버에 자동 배포하는 구조는 피해야 합니다. 자동화 단계에서는 후보값 생성과 시뮬레이션까지만 수행하고 실제 적용은 디자이너 승인과 QA 검증을 거치도록 분리해야 합니다.
피팅 파이프라인은 어떻게 운영하는가?
flowchart LR
    A[게임 로그 수집] --> B[시간당 수급량 집계]
    B --> C[세그먼트 분리]
    C --> D[후보 곡선 생성]
    D --> E[Robust least squares 피팅]
    E --> F[검증 오차와 잔차 확인]
    F --> G[인플레이션 시뮬레이션]
    G --> H[밸런스 파라미터 승인]
운영 주기는 패치 규모에 따라 다르게 잡을 수 있습니다. 신규 스테이지나 새로운 광고 보상이 추가된 경우에는 즉시 재피팅하고 일반적인 수치 조정은 일 단위 또는 주 단위 배치로 처리할 수 있습니다.
피팅 후에는 잔차를 반드시 확인해야 합니다. 잔차가 특정 스테이지나 특정 시간대에서 반복적으로 양수가 되면 단순한 곡선 오차가 아니라 누락된 보상 항이 있을 가능성이 높습니다. 예를 들어 주간 퀘스트 보상이 특정 요일에만 지급된다면 시간당 평균 모델 하나로는 해당 패턴을 설명하기 어렵습니다.
자주 묻는 질문 FAQ
생성형 AI 없이도 AI 자동 피팅이라고 부를 수 있는가?
가능합니다. 이 문맥의 AI 자동 피팅은 데이터에서 최적 파라미터를 찾는 통계적 추정과 최적화 자동화를 뜻합니다. 중요한 것은 이름보다 입력 로그, 목적 함수, 검증 오차를 재현할 수 있는지입니다.
시간당 골드 수급량은 평균과 중앙값 중 무엇을 사용해야 하는가?
일반적인 플레이 감각을 볼 때는 중앙값이 안전하고 서버 전체 골드 총량을 예측할 때는 가중 평균이 필요합니다. 두 값을 모두 계산해 고과금 유저나 광고 헤비 유저가 평균을 얼마나 끌어올리는지 확인해야 합니다.
오프라인 보상은 수급량 모델에 포함해야 하는가?
포함해야 합니다. 다만 활성 플레이 보상과 분리된 항으로 모델링해야 합니다. offline_seconds와 cap_seconds를 이용해 실제 지급량과 상한을 따로 검증하면 장기 미접속 후 인플레이션이 발생하는 문제를 쉽게 찾을 수 있습니다.
정리
방치형 게임의 골드 인플레이션은 감으로 판단하기보다 시간당 수급량과 소비량을 같은 기준으로 측정해야 합니다. Pandas와 SciPy least_squares를 이용해 세그먼트별 성장 곡선을 피팅하고 검증 오차와 잔차를 확인하면 보상 증가율, 오프라인 상한, 광고 배율, 강화 비용 중 어떤 파라미터가 경제를 움직이는지 분리할 수 있습니다.
가장 안전한 운영 방식은 로그 수집, 자동 피팅, 시나리오 시뮬레이션, 디자이너 승인, QA 검증을 독립된 단계로 두는 것입니다. 자동 피팅은 밸런싱 결정을 대신하는 도구가 아니라 인플레이션이 발생하기 전에 경고하고 비교 가능한 근거를 제공하는 도구로 사용하는 것이 적절합니다.