게임 길드 데이터 샤딩 재분배 시점, AI 자동 권고 시스템 설계
게임 길드·클랜 데이터의 샤드 재분배 시점을 AI가 어떻게 판단하는지 설명합니다. 부하·핫키·이동 비용을 점수화하고 안전한 권고·승인·카나리 실행으로 운영 리스크를 줄이는 백엔드 설계와 보안·롤백 기준을 다룹니다.
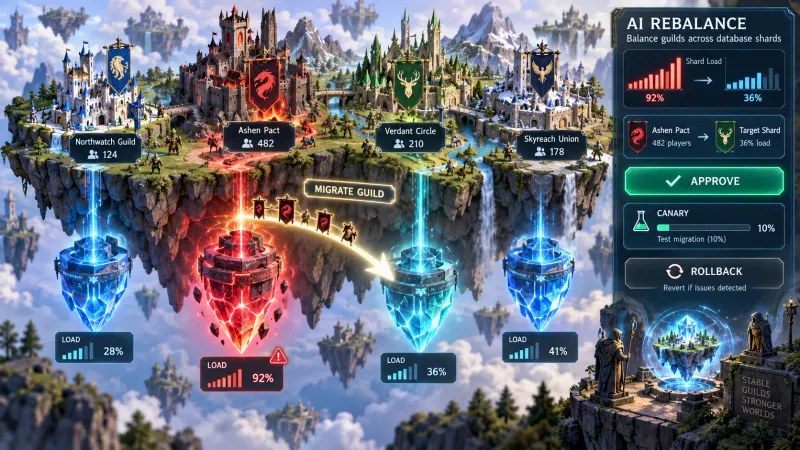
TL;DR: 게임 길드 데이터의 샤드 재분배는 CPU 사용률 하나가 아니라 요청량, 핫키 집중도, 복제 지연, 예상 이동 비용을 함께 평가해야 합니다. AI는 향후 부하와 장애 가능성을 예측하고 재분배 후보와 실행 시점을 권고하며 실제 이동은 정책 게이트·승인·카나리·자동 롤백으로 통제하는 방식이 안전합니다.
게임 길드 데이터 샤딩 재분배 시점은 왜 중요한가?
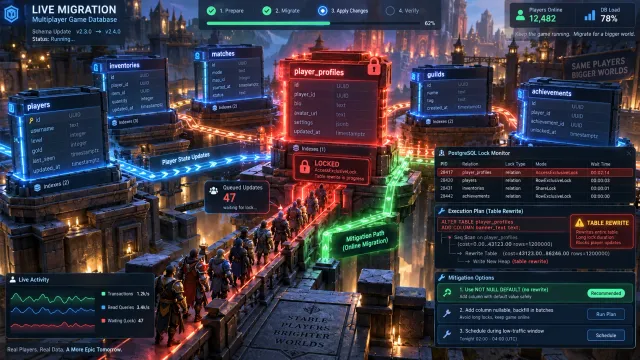
대규모 멀티플레이 게임에서 길드와 클랜은 단순한 사용자 목록이 아닙니다. 길드원 목록, 권한, 창고, 퀘스트 상태, 기부 기록, 전쟁 매칭 정보, 채팅 메타데이터처럼 읽기와 쓰기가 집중되는 데이터가 하나의 논리적 단위로 묶입니다.
초기에는 guild_id를 기준으로 해시 샤딩하면 충분하지만 길드 규모와 활동량은 균등하지 않습니다. 대형 길드 하나가 특정 샤드에 몰리면 전체 샤드의 평균 부하는 정상이어도 해당 샤드의 p99 지연 시간과 락 경합이 급증할 수 있습니다. 반대로 너무 자주 데이터를 옮기면 캐시 미스, 복제 트래픽, 재시도 폭증, 세션 불일치가 발생합니다.
따라서 핵심 문제는 다음과 같습니다.
- 언제 재분배해야 하는가?
- 어떤 길드를 어느 샤드로 옮겨야 하는가?
- 이동 중에도 중복 지급과 데이터 손실을 어떻게 막는가?
- AI의 권고를 어떤 조건에서 자동 승인할 수 있는가?
AI 자동 권고 시스템은 어떤 원리로 동작하는가?
권고 시스템은 데이터 이동을 직접 실행하는 자동화 도구가 아니라 의사결정 보조 계층으로 설계하는 것이 좋습니다. 예시 스택은 다음과 같습니다.
| 영역 | 예시 기술 | 역할 |
|---|---|---|
| 게임 서버 | Java 21 또는 Go 1.23 | 길드 API와 샤드 라우팅 |
| 이벤트 수집 | Kafka 3.7 | 요청량, 명령, 이동 이벤트 스트리밍 |
| 운영 데이터 | PostgreSQL 16, ClickHouse | 상태 저장과 시계열 분석 |
| 캐시 | Redis 7 | 라우팅 테이블과 짧은 TTL 캐시 |
| 예측 모델 | Python 3.12, XGBoost 2.x | 15~60분 뒤 부하와 위험 예측 |
| 권고 API | FastAPI | 점수 계산, 정책 검증, 결과 제공 |
AI 계층은 보통 세 가지 결과를 냅니다.
- 특정 샤드가 과열될 확률
- 길드별 예상 부하와 이동 비용
- 현재 시점의 재분배 권고 여부와 신뢰도
예를 들어 shard-07의 다음 30분 내 p99 지연 시간 초과 확률이 0.91이고 guild-1842를 shard-11로 옮겼을 때 예상 이동량이 420MB라면 권고 시스템은 후보 계획을 생성합니다. 단, 점수가 높아도 시즌 보상 지급이나 길드전 집계 시간이라면 정책 게이트에서 실행을 보류해야 합니다.
길드 샤드 과열 점수는 어떻게 계산하는가?
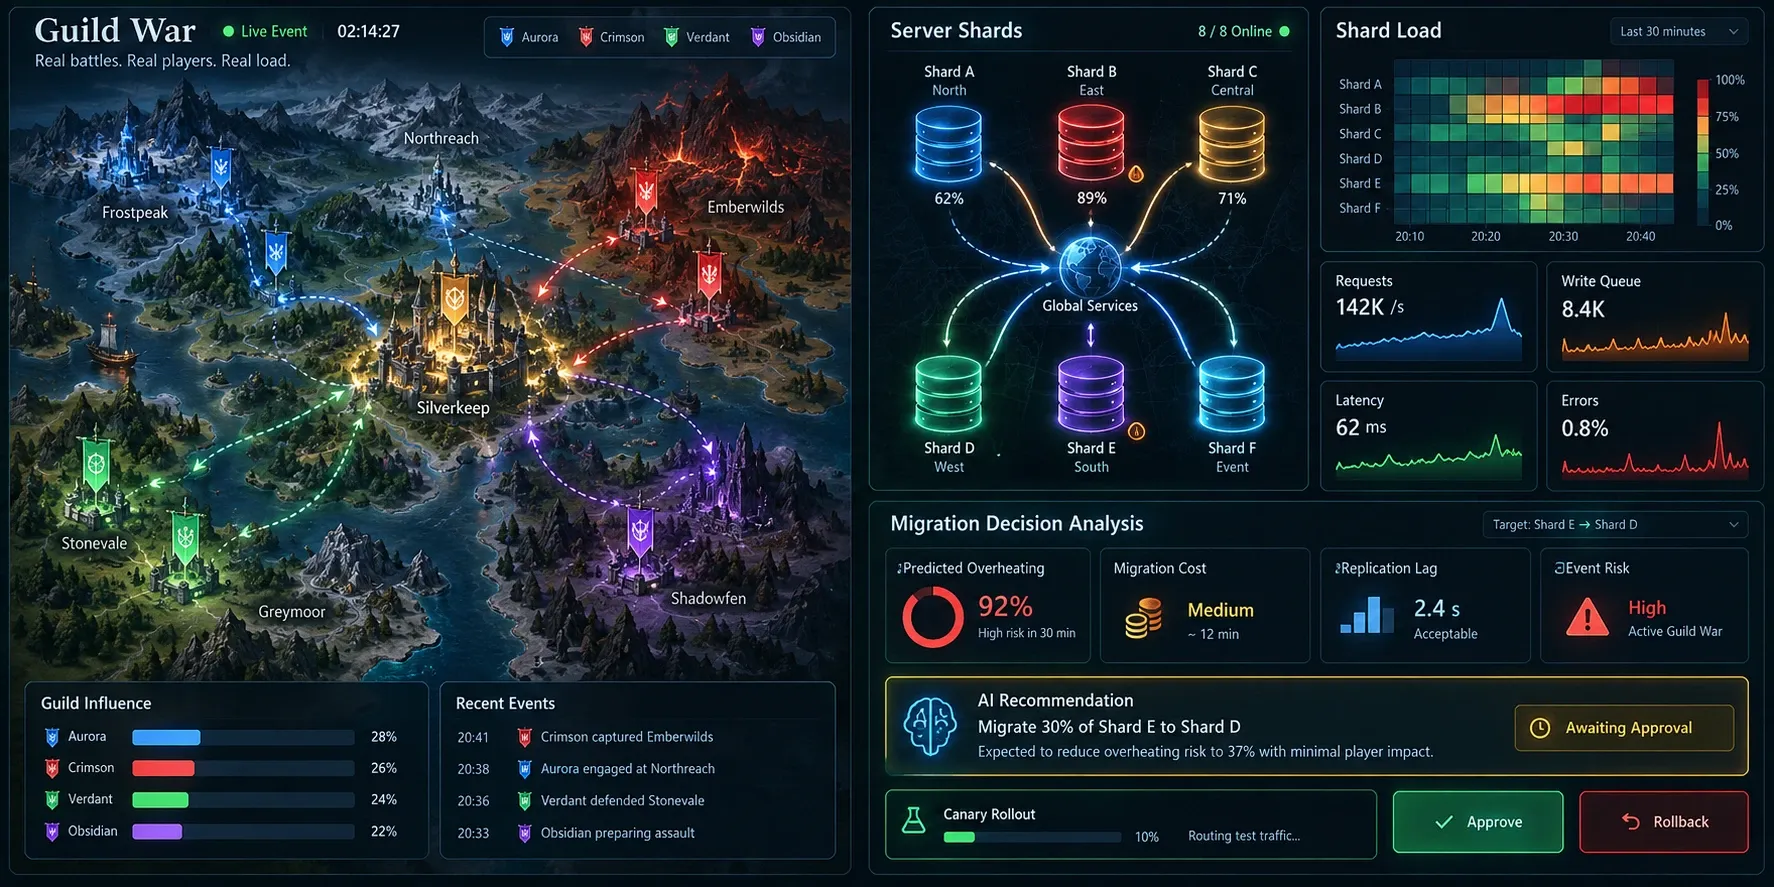
모든 입력값은 최근 5분 또는 15분 구간을 기준으로 0과 1 사이로 정규화합니다. 기본적인 과열 점수는 다음처럼 구성할 수 있습니다.
N은 CPU·메모리·DB 커넥션 사용률, Q는 요청량과 쓰기 큐 길이, P는 p95·p99 지연 시간, E는 에러율과 재시도율입니다. 운영 환경에서는 각 지표의 기준선을 고정하지 말고 리전, 샤드 유형, 이벤트 기간별로 분리해야 합니다.
이동 비용과 안정성 위험도 함께 계산합니다.
B는 이동 바이트 수, K는 관련 키 수, R은 복제 지연 증가 예상치, T는 예상 잠금 또는 라우팅 전환 시간입니다. 최종 권고 점수는 과열을 줄이는 효과와 이동 비용을 함께 반영합니다.
여기서 H_future는 예측된 미래 과열도, G_skew는 샤드 간 부하 편차, R_window은 이벤트 시간대에 따른 운영 위험입니다. S가 임계값을 넘더라도 신뢰도, 쿨다운, 승인 정책을 모두 통과해야 권고가 유효합니다.
어떤 데이터를 AI 모델의 입력으로 사용해야 하는가?
모델 입력은 게임 플레이 맥락과 인프라 상태를 함께 포함해야 합니다. 단순한 CPU 예측만으로는 길드전 시작 직전의 폭발적인 쓰기 요청을 설명하기 어렵습니다.
| 피처 그룹 | 주요 피처 | 수집 주기 |
|---|---|---|
| 트래픽 | 길드 API 요청 수, 읽기·쓰기 비율, 동시 세션 | 10초 |
| 데이터 규모 | 길드원 수, 창고 아이템 수, 이벤트 로그 크기 | 1분 |
| 데이터베이스 | 락 대기 시간, 커넥션 사용률, 인덱스 적중률 | 10초 |
| 안정성 | 에러율, 타임아웃, 재시도 횟수, 복제 지연 | 10초 |
| 게임 일정 | 길드전, 시즌 리셋, 보상 지급, 점검 윈도우 | 이벤트 기반 |
| 이동 상태 | 진행 중인 마이그레이션 수, 예상 바이트, 실패율 | 10초 |
개인정보나 채팅 원문은 이 판단에 필요하지 않습니다. guild_id는 원본 식별자를 그대로 모델에 전달하기보다 해시된 식별자나 집계 피처를 사용합니다. 모델 저장소와 피처 저장소에는 접근 권한을 분리하고 권고 결과에는 원본 사용자 데이터가 포함되지 않도록 해야 합니다.
게임 서버에서 샤드 재분배 권고를 어떻게 구현할까?
1단계: 샤드 단위가 아니라 논리적 길드 단위로 이동 계획을 만든다
길드 데이터가 여러 테이블에 걸쳐 있다면 모든 테이블이 동일한 이동 단위를 가져야 합니다. 예를 들어 guild, guild_member, guild_storage, guild_permission이 guild_id로 연결되어 있다면 길드 단위 스냅샷과 변경 로그를 함께 이동합니다.
대형 길드의 단일 행을 잘게 쪼개는 방식은 읽기 경로와 권한 검증을 복잡하게 만듭니다. 먼저 길드 전체를 하나의 논리적 파티션으로 보고 정말 큰 길드만 guild_id + bucket_id 방식으로 세분화하는 것이 안전합니다.
2단계: 예측 결과를 정책 게이트에 통과시킨다
다음 코드는 Python 3.12와 FastAPI 서비스 내부에서 사용할 수 있는 단순한 권고 판정 예시입니다. 실제 서비스에서는 모델 예측값과 정책 결과를 별도로 저장해 사후 감사가 가능해야 합니다.
from dataclasses import dataclass

@dataclass(frozen=True)
class RebalanceInput:
    future_hotness: float
    load_skew: float
    migration_cost: float
    risk_window: float
    confidence: float
    cooldown_passed: bool
    protected_window: bool

def advise_rebalance(data: RebalanceInput) -> dict:
    score = (
        0.45 * data.future_hotness
        + 0.30 * data.load_skew
        - 0.15 * data.migration_cost
        - 0.10 * data.risk_window
    )

    approved_for_review = (
        score >= 0.72
        and data.confidence >= 0.85
        and data.cooldown_passed
        and not data.protected_window
    )

    return {
        'score': round(score, 4),
        'status': 'review' if approved_for_review else 'hold',
        'reason_codes': [
            'future_hotness_high' if data.future_hotness >= 0.72 else 'hotness_normal',
            'confidence_high' if data.confidence >= 0.85 else 'confidence_low',
            'protected_window' if data.protected_window else 'window_available',
        ],
}review는 즉시 실행이 아니라 운영자 검토 대상이라는 의미로 제한해야 합니다. 자동 실행이 허용되는 경우에도 영향도가 낮은 샤드, 이동량 상한, 동시 이동 수 제한 같은 별도 조건을 추가합니다.
3단계: 이중 쓰기와 원자적 라우팅 전환을 적용한다
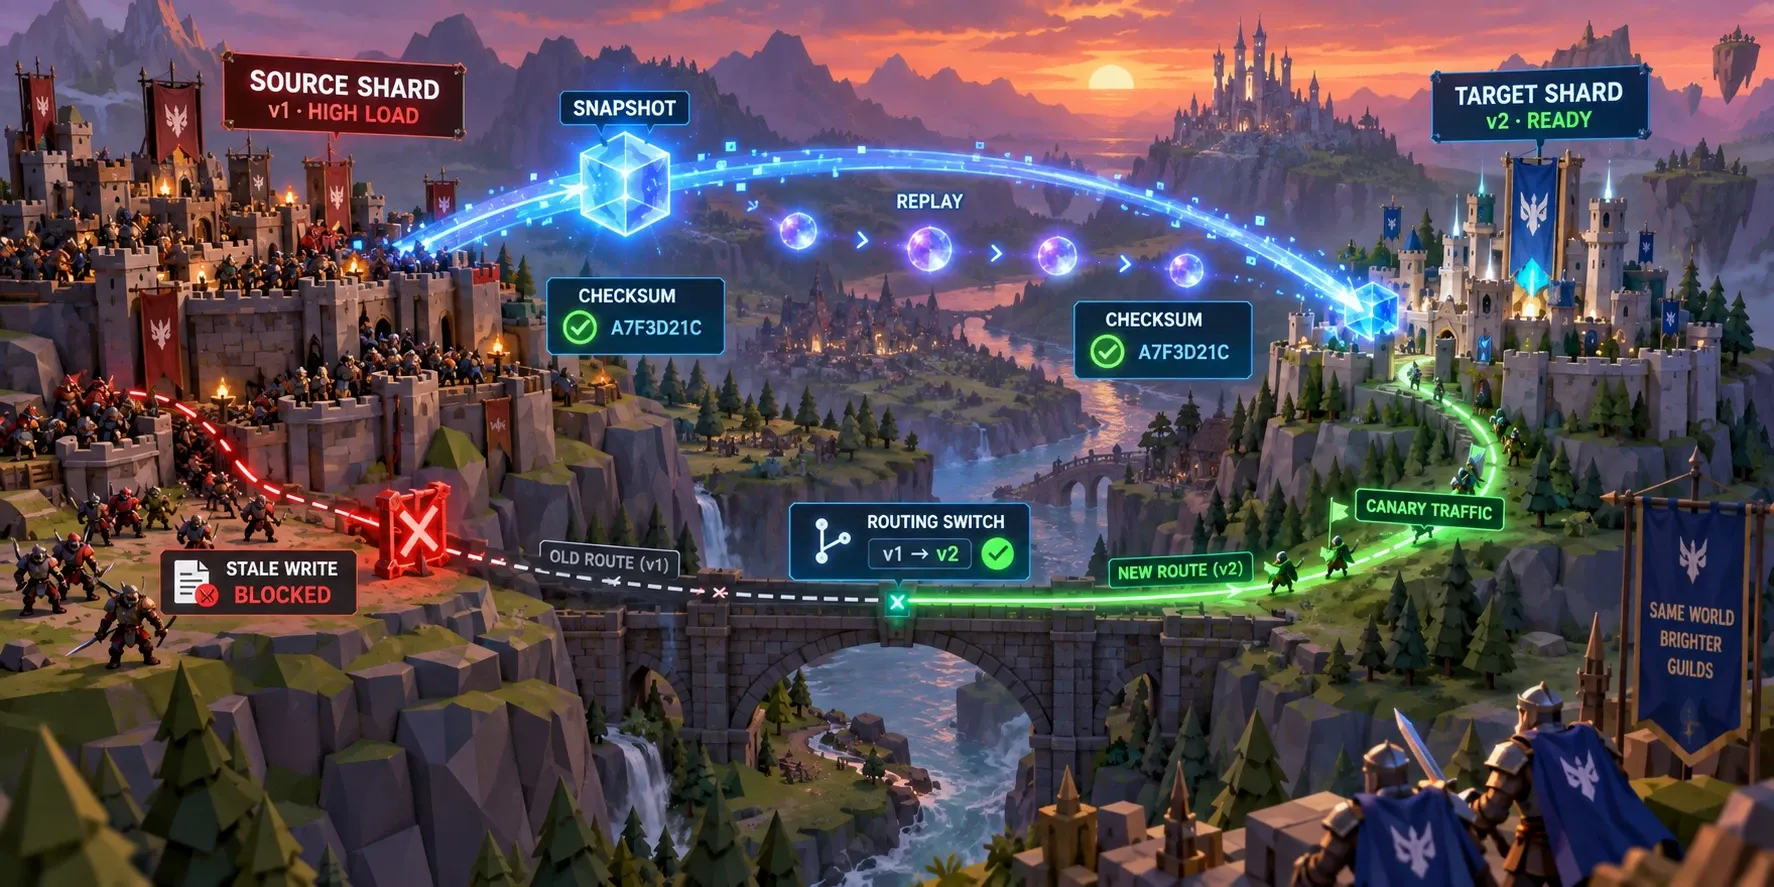
마이그레이션은 다음 순서로 처리합니다.
- 대상 길드에
moving상태와 버전 번호를 기록한다. - 소스 샤드의 스냅샷을 생성하고 대상 샤드에 적재한다.
- 스냅샷 이후 발생한 변경 이벤트를 대상 샤드에 재생한다.
- 소스와 대상의 체크섬, 행 수, 최신 이벤트 오프셋을 비교한다.
- 라우팅 테이블을 한 번에 새 샤드로 전환한다.
- 짧은 검증 기간 동안 읽기를 확인한 뒤 소스 데이터를 보존한다.
라우팅 테이블은 guild_id -> shard_id -> routing_version 구조로 관리합니다. 게임 서버는 요청마다 라우팅 버전을 확인하고 오래된 버전의 쓰기를 거부하거나 재시도해야 합니다. 이 방식은 전환 직후 이전 샤드로 쓰기가 들어가는 문제를 줄입니다.
UPDATE guild_routing
SET shard_id = 'shard-11',
    routing_version = routing_version + 1,
    state = 'active',
    updated_at = now()
WHERE guild_id = 1842
  AND state = 'moving'
  AND routing_version = 38;
조건에 맞는 행이 1개가 아니면 전환을 실패로 처리합니다. 애플리케이션은 이 결과를 검사해 중복 전환이나 경쟁 상태를 차단해야 합니다.
AI 권고 결과를 안전하게 실행하려면 무엇을 검증해야 하는가?
AI 모델이 높은 점수를 반환했다는 사실만으로 실행 권한을 부여하면 안 됩니다. 모델은 학습 데이터에 없는 이벤트나 계절성 변화에 취약할 수 있기 때문입니다.
권고 결과에는 최소한 다음 필드를 포함합니다.
| 필드 | 목적 |
|---|---|
recommendation_id | 추적과 감사 로그 연결 |
model_version | 어떤 모델이 판단했는지 확인 |
feature_snapshot_at | 입력 데이터 시점 고정 |
confidence | 모델 불확실성 표시 |
candidate_moves | 길드와 대상 샤드 목록 |
expected_benefit | 예상 지연 감소와 부하 분산량 |
rollback_condition | 실패 시 자동 중단 기준 |
expires_at | 오래된 권고 재사용 방지 |
보안 관점에서는 권고 API와 마이그레이션 실행 API를 분리합니다. 권고 서비스는 읽기 권한만 가지고 실행 서비스는 짧은 만료 시간의 서명된 명령과 운영자 또는 승인 워크플로의 승인을 요구하도록 구성합니다.
또한 다음 조건은 실행 금지 목록으로 두는 편이 좋습니다.
- 시즌 리셋과 보상 정산 직전
- 길드전 매칭과 결과 집계가 진행 중인 시간
- 데이터베이스 복제 지연이 임계값을 초과한 상태
- 이미 진행 중인 이동이 동시성 한도를 초과한 상태
- 모델 신뢰도가 낮거나 학습 데이터 범위를 벗어난 입력
재분배 기준값은 어떻게 정해야 하는가?
고정 임계값만 사용하면 새벽과 피크 타임의 차이를 반영하지 못합니다. 초기에는 보수적인 고정값으로 시작하되 다음 운영 데이터를 이용해 기준선을 보정합니다.
- 정상 상태의 샤드별 p95와 p99 지연 시간
- 길드전 시작 후 5분 동안의 요청 증가율
- 길드 이동 1건당 평균 바이트와 실패율
- 재분배 이후 15분 동안의 캐시 적중률
- 롤백 발생 비율과 원인 코드
권고에는 히스테리시스를 적용해야 합니다. 예를 들어 과열 판정은 에서 시작하고 해제는 에서만 허용합니다. 이 간격이 없으면 점수가 임계값 주변에서 반복적으로 오르내리며 이동이 연속 실행됩니다.
추가로 길드별 쿨다운을 두고 같은 길드는 최소 6시간 동안 다시 이동하지 않게 합니다. 이동 중인 길드에는 read_only 또는 요청 큐잉 정책을 적용하되 보상 지급처럼 재시도가 위험한 명령은 멱등 키를 사용해야 합니다.
운영 대시보드에는 무엇을 보여줘야 하는가?
운영자는 AI 점수만 보고 승인할 수 없습니다. 권고 근거와 예상 결과를 한 화면에서 확인해야 합니다.
필수 지표는 다음과 같습니다.
- 현재 샤드별 CPU, DB 커넥션, p99 지연 시간
- 재분배 전후의 예상 부하 편차
- 이동 대상 길드의 데이터 크기와 최근 활동량
- 모델 버전과 신뢰도
- 최근 권고의 승인·보류·실패 비율
- 카나리 이동 이후 오류율과 롤백 상태
모델의 결정 이유는 사람이 이해할 수 있는 형태로 남겨야 합니다. 예를 들어 guild-1842가 최근 15분 쓰기 요청의 27%를 차지했고 대상 샤드의 여유 용량이 34%처럼 주요 피처와 기준값을 함께 표시합니다. 이는 장애 분석과 모델 교체 시 유용합니다.
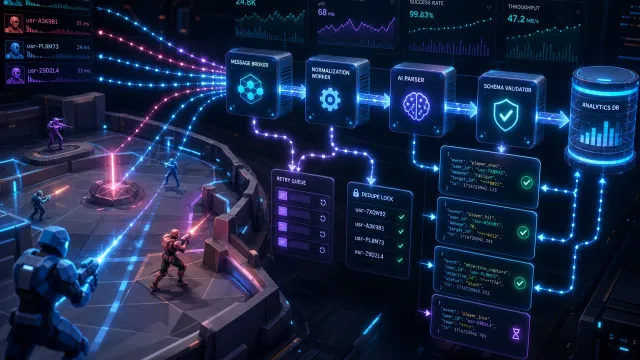
flowchart LR
    A[Metric Events] --> B[Feature Store]
    B --> C[Load Prediction]
    C --> D[Policy Gate]
    D --> E[Operator Approval]
    E --> F[Migration Planner]
    F --> G[Canary Move]
    G --> H[Verify or Rollback]
자주 묻는 질문 FAQ
AI가 재분배를 자동으로 실행해도 되는가?
장애가 임박한 저위험 이동에는 제한적으로 자동 실행할 수 있지만 기본값은 권고와 승인 분리입니다. 이동량, 이벤트 시간, 신뢰도, 동시성 한도를 모두 검증한 뒤 카나리로 시작해야 합니다.
길드 데이터를 샤딩할 때 가장 안전한 샤드 키는 무엇인가?
대부분의 길드 기능이 guild_id로 접근되므로 기본 샤드 키는 guild_id가 적합합니다. 길드 규모 편차가 매우 크면 대형 길드에만 guild_id + bucket_id를 적용하고 권한과 트랜잭션 경계를 함께 재설계해야 합니다.
마이그레이션 중 데이터 중복과 유실을 어떻게 방지하는가?
스냅샷, 변경 이벤트 재생, 체크섬 검증, 라우팅 버전의 원자적 전환, 멱등 키를 조합합니다. 검증이 끝나기 전에는 소스 데이터를 삭제하지 않고 오류율이나 체크섬 불일치가 발생하면 이전 라우팅 버전으로 되돌립니다.
정리
게임 길드 데이터 샤딩 재분배는 단순한 서버 증설 문제가 아니라 부하 예측, 데이터 이동 비용, 게임 이벤트 일정, 일관성 보장을 함께 다루는 운영 문제입니다.
실용적인 AI 자동 권고 시스템은 예측 모델 → 정책 게이트 → 승인 → 카나리 이동 → 검증·롤백의 흐름을 갖춰야 합니다. 특히 AI는 판단 근거와 신뢰도를 남기고 실제 데이터 변경 권한은 별도의 보안 경계 안에 두어야 합니다. 이렇게 설계하면 핫스팟을 조기에 완화하면서도 불필요한 이동과 대규모 장애를 통제할 수 있습니다.