인게임 세션 데이터 로그를 실시간 AI 파싱해 DB 파이프라인으로 자동화하는 방법
멀티플레이 게임의 세션 로그를 수집·정규화·AI 파싱·검증·적재하는 실시간 파이프라인을 설계한다. 지연 시간, 개인정보, 중복 처리, 스키마 변경까지 고려한 서버 구현 기준과 예시를 정리한다.
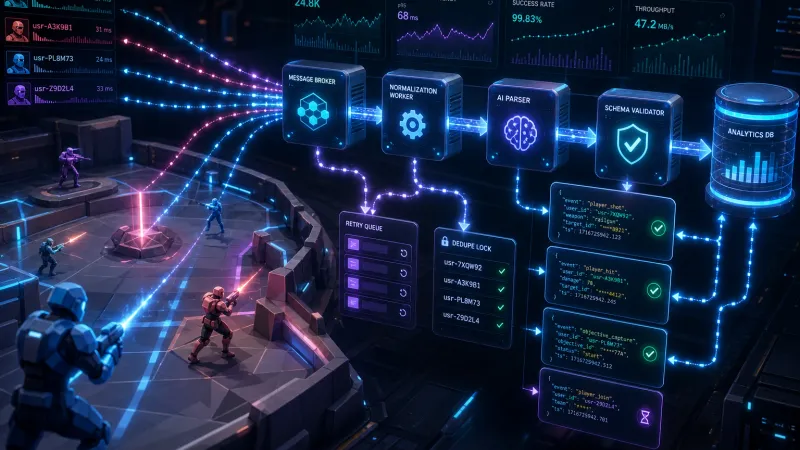
게임 세션 로그의 실시간 AI 파싱은 원본 이벤트를 그대로 LLM에 보내는 작업이 아니다. 서버에서 이벤트를 안정적으로 수집하고 스키마를 정규화한 뒤 AI가 구조화한 결과를 규칙 기반 검증과 멱등성 보장 절차를 거쳐 분석용 DB에 적재하는 파이프라인이다. 핵심은 게임 플레이 경로에는 AI 호출을 넣지 않고, 비동기 분석 경로에서 처리하는 것이다.
인게임 세션 데이터 로그 파이프라인은 왜 분리해야 하는가?
매치 서버의 핵심 루프는 낮은 지연 시간과 예측 가능한 처리 시간을 요구한다. 반면 LLM API 호출은 네트워크 지연, 공급자 장애, 토큰 비용, 응답 형식 오류를 수반한다. 따라서 MatchServer는 이벤트 발행까지만 담당하고 AI 분석은 메시지 브로커 이후의 워커가 맡아야 한다.
| 구간 | 책임 | 권장 기술 예시 | 실패 시 처리 |
|---|---|---|---|
| 게임 서버 | 이벤트 생성과 발행 | Go, Rust, Node.js, OpenTelemetry | 로컬 버퍼 또는 재시도 큐 |
| 스트림 | 순서 보존과 완충 | Kafka, Redpanda, AWS Kinesis | 보존 기간 내 재처리 |
| 정규화 워커 | 버전 변환, PII 제거 | Flink, Kafka Streams, 소비자 워커 | DLQ 전송 |
| AI 파서 | 의미 분류, 요약, 이상 징후 추출 | JSON Schema 출력 LLM | 타임아웃·재시도 |
| 저장소 | 원본과 분석 결과 보관 | S3, PostgreSQL, ClickHouse | 멱등 UPSERT |
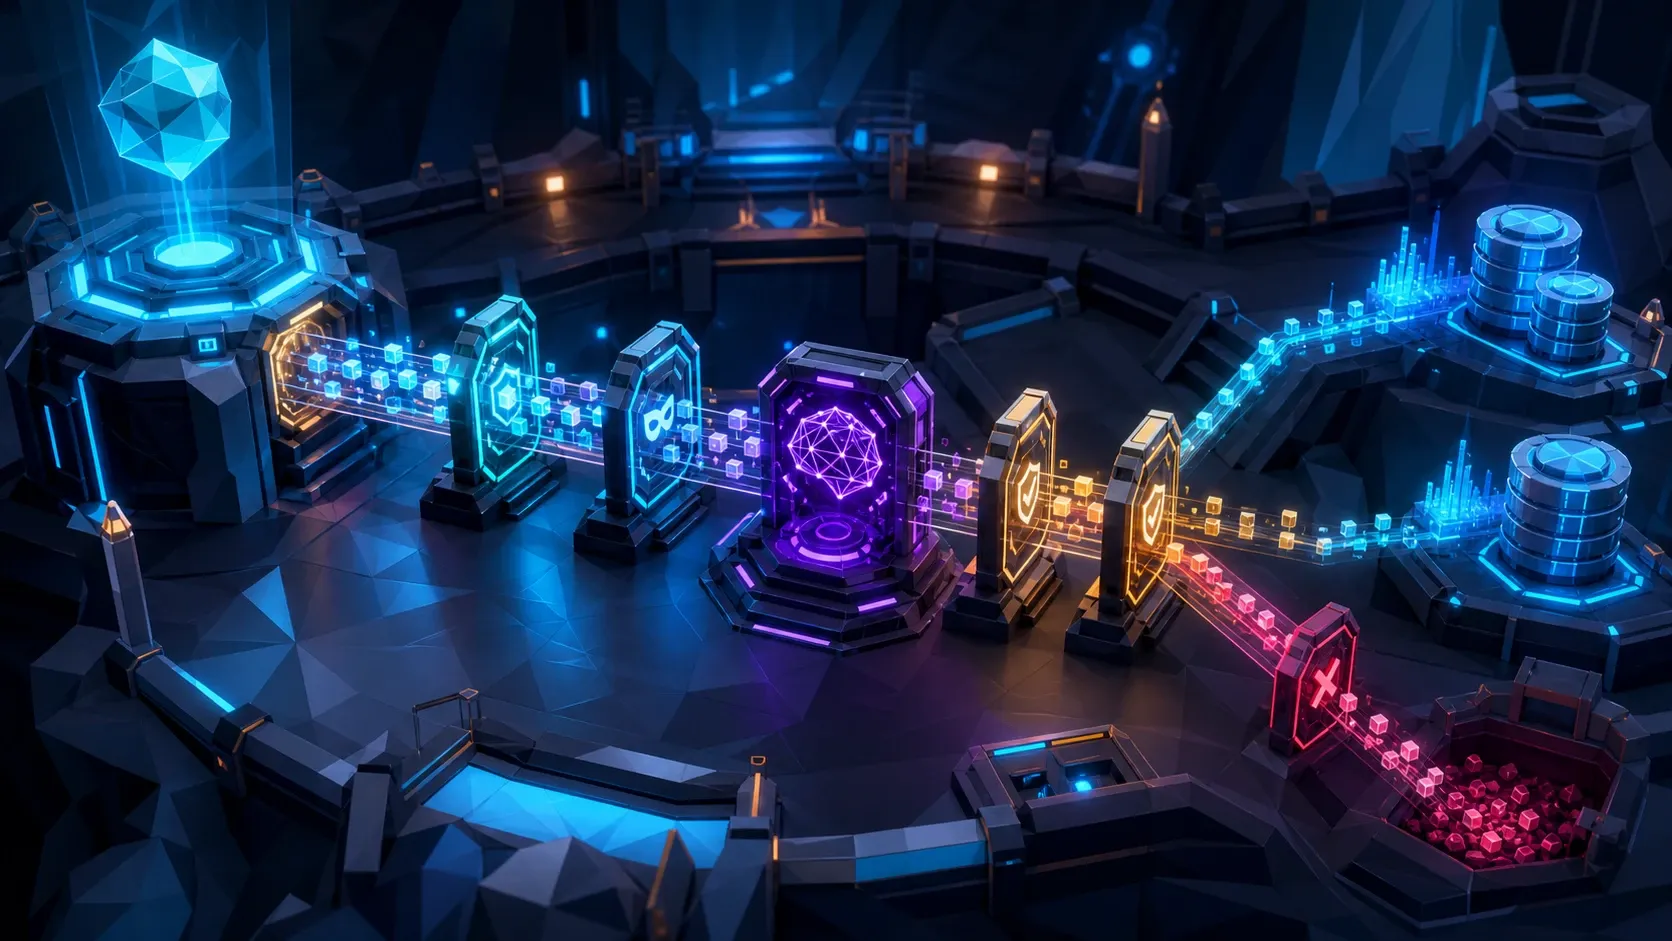
player_died, item_purchased, match_ended처럼 이미 구조화된 이벤트는 AI 없이 집계하는 편이 정확하고 저렴하다. AI 파싱은 채팅 신고 사유, 운영 메모, 비정형 오류 로그, 플레이 패턴 설명처럼 규칙만으로 해석하기 어려운 데이터에 한정한다.
실시간 AI 로그 파싱 DB 파이프라인 구조
다음 구조는 게임 진행 데이터와 분석 데이터의 장애 전파를 분리한다.
flowchart LR
    A[Match Server] --> B[Event Topic]
    B --> C[Normalizer]
    C --> D[Raw Archive]
    C --> E[AI Parse Queue]
    E --> F[LLM Worker]
    F --> G[Schema Validator]
    G --> H[(Analytics DB)]
    G --> I[Dead Letter Queue]
원본 이벤트는 객체 스토리지에 보관하고 AI 결과는 별도 테이블에 저장한다. 이렇게 하면 프롬프트나 모델을 바꾼 뒤에도 원본 로그를 다시 파싱할 수 있다.
이벤트 계약은 어떻게 설계할까?
이벤트마다 event_id, schema_version, session_id, occurred_at을 고정 필드로 둔다. event_id는 UUIDv7 또는 시간 정렬 가능한 식별자를 쓰면 재처리와 추적이 편하다.
{
  "event_id": "019b5de4-0f70-7b72-bf49-b771cd7a9801",
  "schema_version": 3,
  "session_id": "match_20260811_8f9c",
  "match_id": "ranked-kr-482991",
  "player_id_hash": "sha256:8e3c...",
  "event_name": "player_report_note",
  "occurred_at": "2026-08-11T11:20:14.382Z",
  "payload": {
    "report_reason": "abusive_chat",
    "note": "후반부터 팀원을 반복적으로 비난함"
  }
}
계정 ID, IP 주소, 채팅 원문은 분석 목적에 맞춰 최소화한다. AI에 플레이어 식별자가 필요 없다면 player_id 대신 단방향 해시나 세션 내 가명 ID를 전달한다. 개인정보가 포함된 원문을 외부 모델에 전송할 때는 서비스 약관, 보관 위치, 접근 통제를 별도로 검토해야 한다.
AI 파싱 결과를 신뢰할 수 있게 만드는 3단계
1. 입력을 정규화하고 크기를 제한한다
비정형 로그를 그대로 합치면 프롬프트 인젝션과 비용 폭증에 취약하다. 이벤트 타입별 허용 필드를 지정하고 텍스트 길이와 배치 크기를 제한한다.
여기서 T_max는 모델별 입력 토큰 상한보다 충분히 낮게 잡은 운영 한도다. 예를 들어 8,000 토큰 모델 입력을 쓴다고 해서 배치를 8,000 토큰까지 채우지 말고 시스템 프롬프트와 출력 여유를 고려해 4,000~6,000 토큰 범위에서 시작한다.
2. 자유 텍스트 대신 JSON Schema 출력을 강제한다
AI 출력은 사람에게 읽기 좋은 문장이 아니라 DB에 넣을 수 있는 엄격한 데이터여야 한다. 모델에 허용된 열거값과 타입을 명시하고 서버에서 다시 검증한다.
const parsedSessionSchema = {
  type: "object",
  additionalProperties: false,
  required: ["event_id", "toxicity_level", "summary", "action"],
  properties: {
    event_id: { type: "string" },
    toxicity_level: {
      type: "string",
      enum: ["none", "low", "medium", "high"]
    },
    summary: { type: "string", maxLength: 240 },
    action: {
      type: "string",
      enum: ["ignore", "queue_for_review", "escalate"]
    }
  }
};summary나 action은 모델의 제안일 뿐 최종 제재 결정이 아니다. 계정 제재처럼 영향이 큰 작업은 운영 정책 엔진과 사람 검토 단계를 둬야 한다.
3. 검증 뒤 멱등 UPSERT로 저장한다
메시지 브로커는 일반적으로 at-least-once 전달을 사용하므로 중복 소비가 발생할 수 있다. event_id + parser_version에 유니크 제약을 걸고 UPSERT를 사용하면 재시도해도 같은 결과가 여러 번 쌓이지 않는다.
CREATE TABLE ai_session_annotations (
  event_id UUID NOT NULL,
  parser_version TEXT NOT NULL,
  toxicity_level TEXT NOT NULL,
  summary TEXT NOT NULL,
  action TEXT NOT NULL,
  model_name TEXT NOT NULL,
  created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
  PRIMARY KEY (event_id, parser_version)
);

INSERT INTO ai_session_annotations (
  event_id, parser_version, toxicity_level, summary, action, model_name
) VALUES ($1, $2, $3, $4, $5, $6)
ON CONFLICT (event_id, parser_version)
DO UPDATE SET
  toxicity_level = EXCLUDED.toxicity_level,
  summary = EXCLUDED.summary,
  action = EXCLUDED.action,
  model_name = EXCLUDED.model_name;
지연 시간과 비용은 어떻게 계산할까?
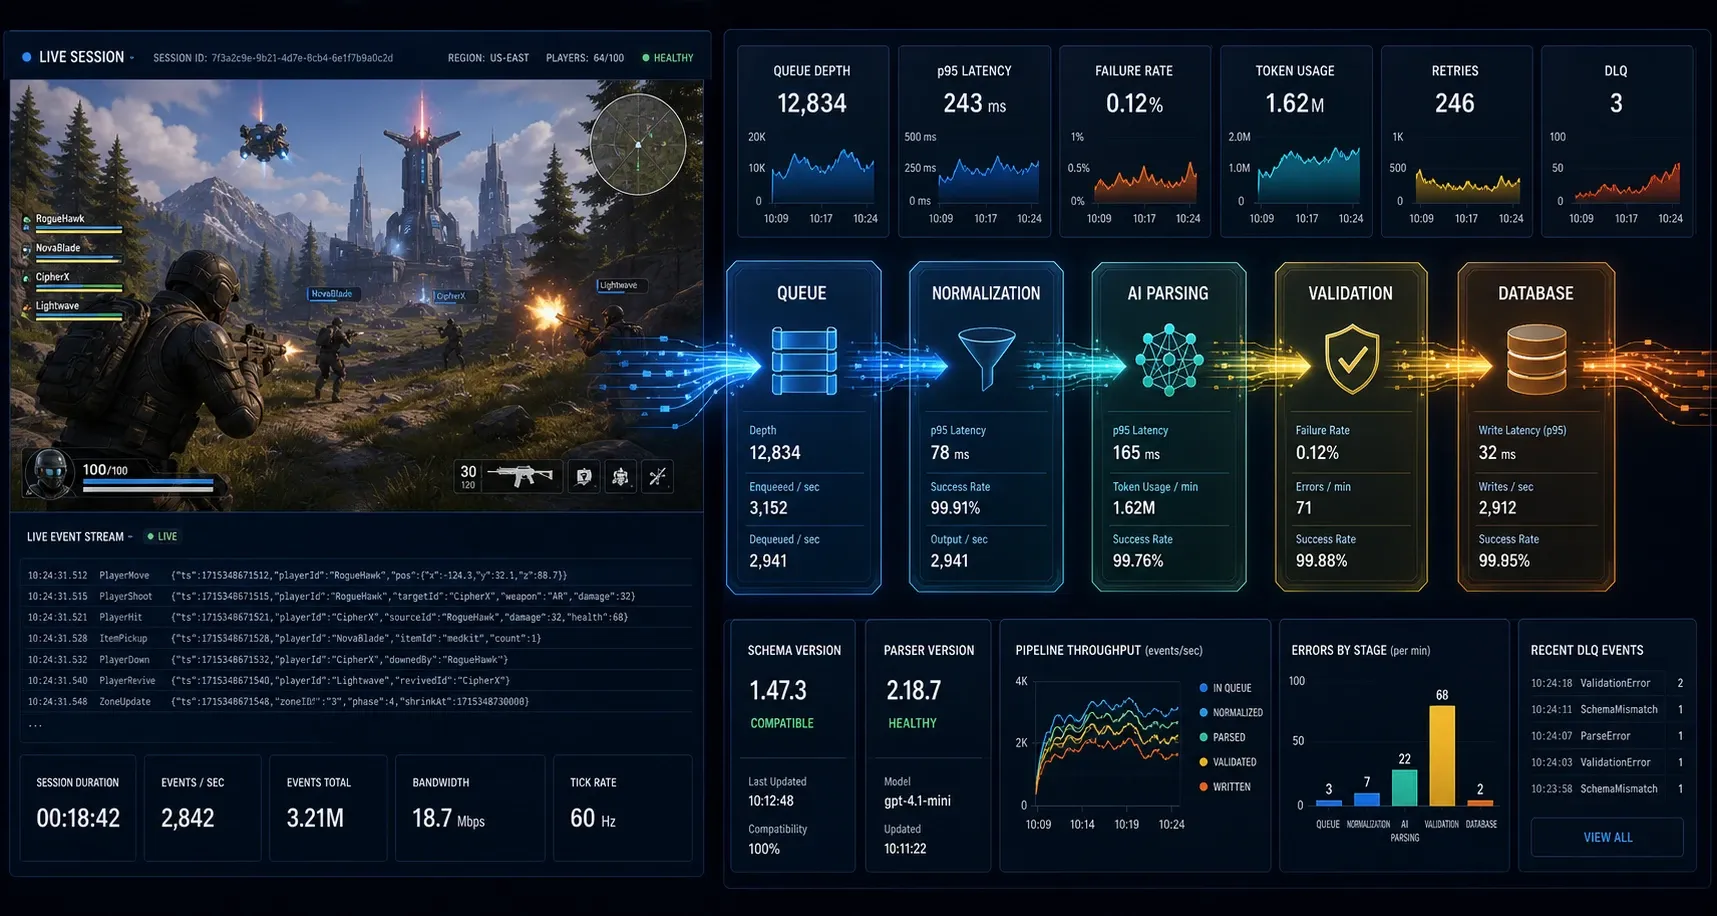
실시간이라는 말은 반드시 플레이 중 즉시 응답을 뜻하지 않는다. 운영 대시보드나 매치 종료 후 분석이라면 수 초~수 분 지연을 허용할 수 있다. 목표를 p95 end-to-end latency로 정하고 큐 적체와 모델 지연을 분리해 관측한다.
비용은 이벤트 전체 수보다 AI로 보내는 이벤트 비율이 좌우한다. 먼저 규칙 기반 필터로 무관한 이벤트를 제거하고 같은 세션의 문맥이 필요한 이벤트만 짧은 배치로 묶는다. 모델명, 프롬프트 버전, 입력·출력 토큰 수, 처리 결과를 함께 기록하면 비용 급증 원인을 추적할 수 있다.
운영에서 반드시 확인할 장애 시나리오
- 모델 응답 지연: 짧은 타임아웃과 지수 백오프를 적용하고 한도 초과 이벤트는 DLQ로 보낸다.
- 스키마 변경:
schema_version과parser_version을 분리한다. 이벤트 형식 변경과 AI 해석 로직 변경은 서로 다른 문제다. - 순서 역전: 세션 단위 맥락이 필요하면
session_id를 파티션 키로 사용한다. 완벽한 전역 순서보다 세션 내 순서가 중요하다. - 환각 또는 오분류: JSON Schema 검증은 형식만 보장한다. 샘플링 감사, 정답 라벨 데이터셋, 정밀도·재현율 측정이 필요하다.
- DB 과부하: 원본 로그는 OLTP DB가 아니라 객체 스토리지나 로그 저장소에 두고 운영 조회와 집계는 ClickHouse 같은 분석 저장소로 분리한다.
자주 묻는 질문 (FAQ)
AI 파서는 모든 게임 이벤트에 적용해야 하나요?
아니다. 좌표 이동, 피해량, 상점 구매처럼 결정론적으로 집계할 수 있는 이벤트는 SQL이나 스트림 집계가 더 빠르고 저렴하다. AI는 비정형 텍스트와 복합 맥락 해석에 사용한다.
Kafka가 없으면 구현할 수 없나요?
아니다. 초기 규모에서는 관리형 큐와 워커로 시작할 수 있다. 다만 재처리, 보존, 파티션 순서, 소비 지연 관측이 필요해지면 Kafka 또는 Redpanda 같은 스트림 플랫폼의 장점이 커진다.
AI 결과를 곧바로 자동 제재에 사용해도 되나요?
권장하지 않는다. 먼저 운영자 검토 큐, 규칙 기반 임계값, 이의 제기와 감사 로그를 포함한 정책 절차를 마련해야 한다.
정리
안전한 인게임 세션 로그 자동화의 출발점은 게임 서버와 AI 처리 경로를 분리하는 것이다. 구조화 이벤트 계약, 원본 보관, JSON Schema 출력, 서버 측 검증, 멱등 저장을 기본으로 두면 모델을 교체하거나 분석 기준을 바꿔도 파이프라인을 안정적으로 운영할 수 있다.