게임 서버 인메모리 캐싱 전략: Redis·Memcached 분산 처리 설계와 장애 대응
멀티플레이 게임 서버에서 Redis와 Memcached를 활용해 DB 부하와 지연 시간을 줄이는 분산 캐싱 전략을 설명합니다. 키 설계, TTL, 캐시 무효화, 샤딩, 장애 대응, 운영 지표까지 실무 기준으로 정리합니다.
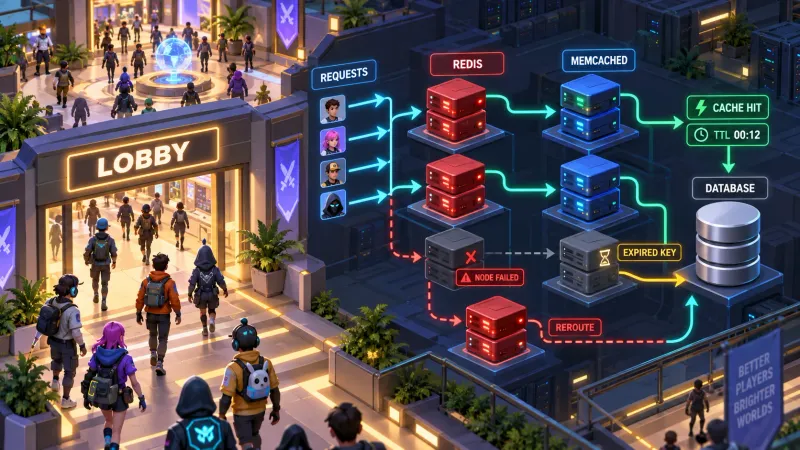
게임 서버의 인메모리 캐싱은 자주 읽는 데이터를 Redis 또는 Memcached의 메모리에 두어 데이터베이스 왕복을 줄이는 전략이다. 핵심은 단순히 데이터를 복사하는 것이 아니라 데이터 특성에 맞춰 TTL, 무효화 방식, 샤드 위치, 장애 시 원본 DB 조회 정책을 함께 설계하는 데 있다. 세션·랭킹·매치메이킹처럼 원자 연산과 자료구조가 필요한 데이터는 Redis가 적합하고 단순 조회 결과를 대량 캐싱할 때는 Memcached가 효율적일 수 있다.
게임 서버에서 분산 인메모리 캐싱은 왜 필요한가?
멀티플레이 게임은 로그인, 로비 진입, 친구 목록, 인벤토리 조회, 상점 상품 조회처럼 읽기 요청이 집중되는 경로가 많다. 이 요청이 모두 MySQL이나 PostgreSQL로 향하면 DB 커넥션, 디스크 I/O, 락 경합이 먼저 병목이 된다.
캐시는 애플리케이션 서버와 원본 DB 사이에 읽기 전용에 가까운 고속 계층을 추가한다. 일반적인 Cache-Aside 패턴의 흐름은 다음과 같다.
flowchart LR
  C[게임 클라이언트] --> A[게임 API 서버]
  A -->|GET cache key| R[(Redis 또는 Memcached)]
  R -->|Cache Hit| A
  R -->|Cache Miss| A
  A --> D[(원본 DB)]
  D --> A
  A -->|SET with TTL| R
  A --> C
캐시가 유효한 동안 DB 조회를 생략할 수 있으므로 평균 응답 시간과 DB 부하가 함께 감소한다. 다만 캐시는 원본 데이터가 아니므로 최신성, 만료, 장애 상황을 명시적으로 다뤄야 한다.
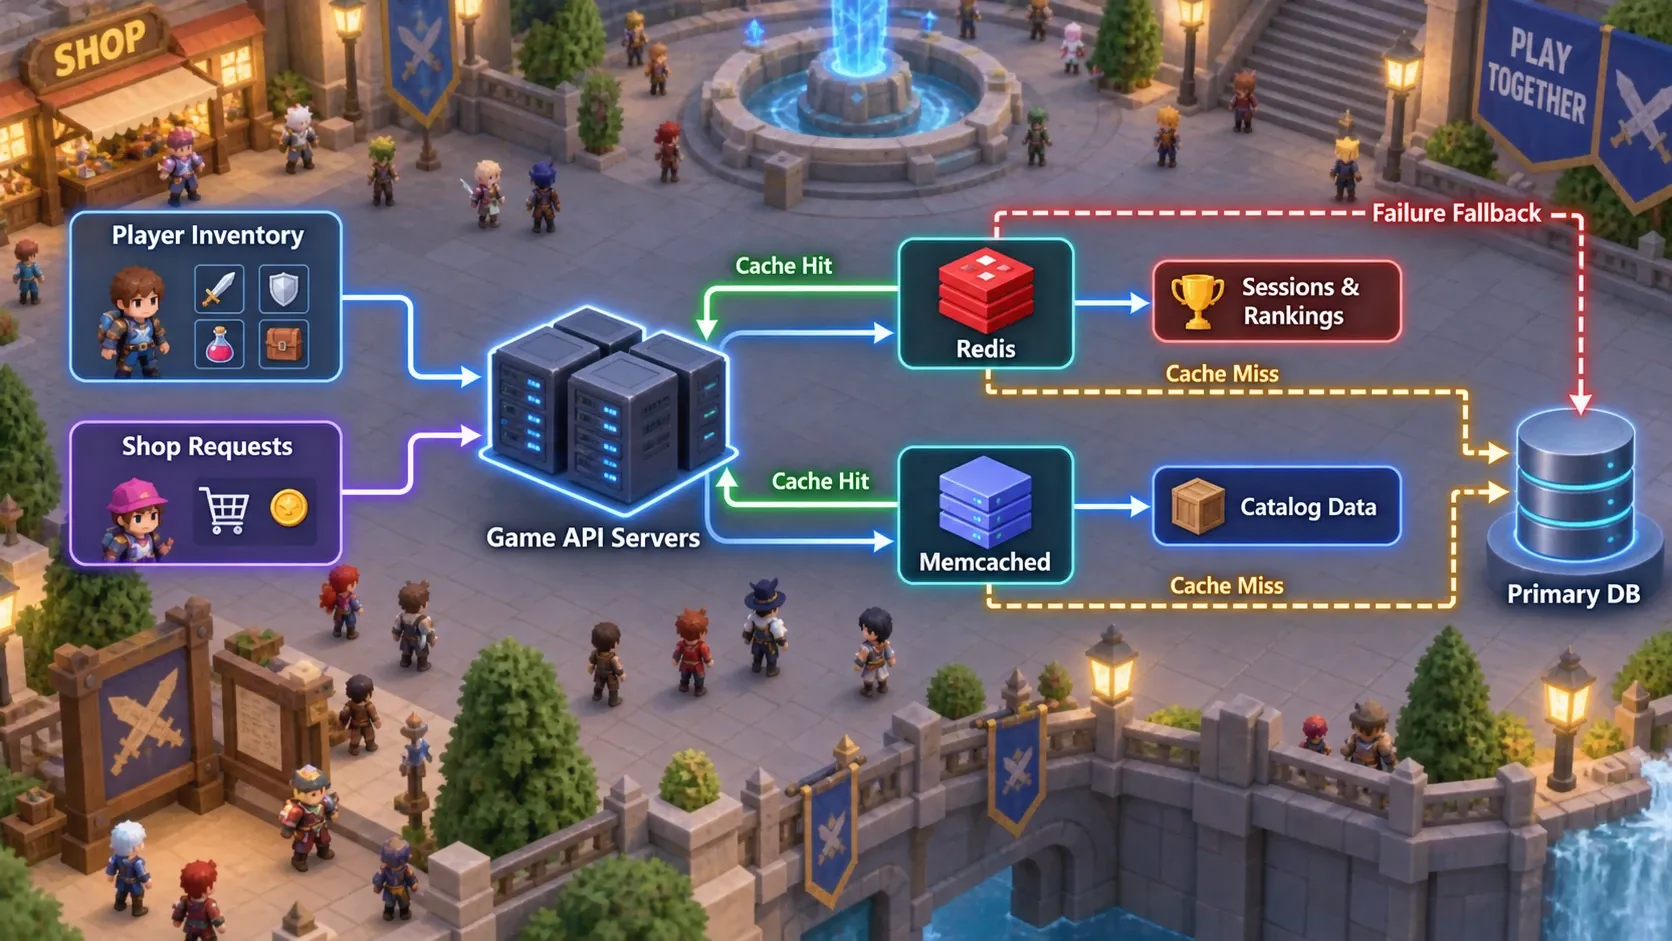
Redis와 Memcached는 게임 서버에서 어떻게 선택할까?
| 기준 | Redis | Memcached |
|---|---|---|
| 데이터 모델 | 문자열, Hash, Set, Sorted Set, Stream 등 | 단순 키-값 |
| 원자 연산 | INCR, Lua Script, 트랜잭션 등 지원 | 제한적 |
| 영속화 | RDB 스냅샷, AOF 선택 가능 | 기본적으로 비영속 |
| 복제·고가용성 | Redis Sentinel, Redis Cluster | 클라이언트 중심 분산 구성이 일반적 |
| 적합한 게임 데이터 | 세션, 랭킹, 분산 락, 레이트 리밋, 매치 큐 | 상품 카탈로그, 정적 설정, DB 조회 결과 |
Redis는 언제 선택해야 하는가?
다음처럼 데이터 조작 자체가 필요한 경우 Redis를 우선 검토한다.
- 실시간 랭킹:
ZINCRBY leaderboard:season:12 score playerId - 로그인 세션:
SET session:{userId} token EX 1800 - 레이트 리밋:
INCR rate:{userId}:{minute}와EXPIRE - 매치메이킹 대기열: Sorted Set의 점수에 MMR과 대기 시간을 반영
- 원자적 재화 처리 보조: Lua Script로 검증과 변경을 한 번에 수행
Redis의 메모리 데이터도 영구 저장소를 완전히 대체하지는 않는다. 유료 재화, 인벤토리, 결제 상태 같은 핵심 데이터의 최종 정합성은 트랜잭션 DB 또는 이벤트 로그에 둬야 한다.
Memcached는 언제 선택해야 하는가?
Memcached는 구조가 단순하고 순수한 조회 캐시에 잘 맞는다. 예를 들어 몇 분 단위로 갱신되는 상점 상품 목록, 게임 밸런스 테이블, 지역별 공지 목록처럼 값 전체를 읽는 데이터에 적합하다.
Memcached의 항목이 축출되거나 노드가 재시작되어도 애플리케이션이 DB에서 다시 읽어 채울 수 있어야 한다. 따라서 원본 없이 Memcached만 신뢰하는 설계는 피한다.
게임 서버 캐시 키와 TTL은 어떻게 설계할까?
키는 충돌 없이 데이터의 범위와 버전을 드러내야 한다. 운영자가 Redis CLI 또는 모니터링 도구로 키를 봤을 때 의미를 파악할 수 있는 형태가 좋다.
| 데이터 | 권장 키 예시 | TTL 예시 | 무효화 방식 |
|---|---|---|---|
| 플레이어 프로필 | player:profile:{playerId}:v3 | 5~30분 | 프로필 저장 뒤 삭제 |
| 상점 상품 | catalog:shop:{region}:v8 | 10~60분 | 배포·상품 변경 시 버전 변경 |
| 로그인 세션 | session:{sessionId} | 30분 | 활동마다 TTL 연장 |
| 친구 목록 | social:friends:{playerId} | 1~5분 | 친구 관계 변경 뒤 삭제 |
| 시즌 랭킹 | rank:season:{seasonId} | 데이터 구조 자체 관리 | 시즌 종료 후 만료 |
{playerId} 표기는 Redis Cluster에서 해시 태그로도 사용할 수 있다. 예를 들어 inventory:{12345}와 currency:{12345}는 같은 해시 슬롯에 배치되어 같은 플레이어 범위의 Lua Script 또는 다중 키 연산을 설계하기 쉬워진다.
TTL은 데이터 변경 주기와 허용 가능한 오래된 데이터 범위로 정한다. 키가 만료 전에 반복 조회되고 다른 이유로 축출되지 않는다고 가정하면, 만료 시 재조회되는 단순 캐시 키의 DB 조회 빈도는 TTL 에 따라 대략 다음과 같이 제한된다. 여기서 빈도 단위는 TTL의 역수이며, 요청이 거의 없는 키에는 이 근사가 적용되지 않는다.
단, 만료 직후 여러 요청이 동시에 들어오는 캐시 스탬피드 상황은 이 근사보다 훨씬 큰 순간 부하를 만든다.
Cache-Aside 패턴을 게임 API에 어떻게 구현할까?
가장 널리 쓰이는 방식은 읽을 때 캐시를 먼저 확인하고 없으면 DB에서 읽어 캐시에 저장하는 Cache-Aside다. 쓰기 요청은 DB 트랜잭션을 성공시킨 뒤 관련 캐시 키를 삭제한다.
1. 읽기 경로에서 캐시를 먼저 조회한다
Node.js와 ioredis 기준의 단순 예시는 다음과 같다.
import { Redis } from "ioredis";

const redis = new Redis(process.env.REDIS_URL);
const PROFILE_TTL_SECONDS = 300;

type PlayerProfile = {
  id: string;
  nickname: string;
  level: number;
};

export async function getPlayerProfile(playerId: string): Promise<PlayerProfile> {
  const key = `player:profile:{${playerId}}:v3`;
  const cached = await redis.get(key);

  if (cached) {
    return JSON.parse(cached) as PlayerProfile;
  }

  const profile = await playerRepository.findById(playerId);
  if (!profile) throw new Error("PLAYER_NOT_FOUND");

  await redis.set(key, JSON.stringify(profile), "EX", PROFILE_TTL_SECONDS);
  return profile;
}
2. 쓰기 성공 뒤 캐시를 삭제한다
DB를 먼저 갱신하고 트랜잭션이 커밋된 뒤 캐시를 삭제한다. 캐시 값을 직접 갱신하는 방식보다 구현이 단순하고 오래된 값이 남는 경우를 줄이기 쉽다.
export async function changeNickname(playerId: string, nickname: string) {
  await database.transaction(async (tx) => {
    await playerRepository.updateNickname(tx, playerId, nickname);
  });

  await redis.del(`player:profile:{${playerId}}:v3`);
}
3. 실패 시 원본 DB로 안전하게 폴백한다
Redis 장애가 게임 전체 장애로 번지지 않도록 캐시 접근에는 짧은 타임아웃을 두고 실패 시 DB 조회를 수행한다. 단, DB가 이미 포화 상태라면 무제한 폴백은 더 큰 장애를 만든다. 서킷 브레이커, 요청 제한, 중요하지 않은 기능의 임시 축소를 함께 적용해야 한다.
캐시 스탬피드와 핫키는 왜 발생하는가?
캐시 스탬피드는 인기 키가 동시에 만료되어 수백 또는 수천 개의 요청이 원본 DB를 함께 조회하는 현상이다. 신작 출시 직후의 공지, 월드 보스 상태, 인기 스트리머의 프로필처럼 특정 키에 요청이 몰리면 핫키 문제가 된다.
캐시 스탬피드 대응 방법
- TTL 지터를 추가한다. 기본 TTL 300초에 0~60초의 난수를 더해 키가 한꺼번에 만료되지 않게 한다.
- 단일 비행 요청을 적용한다. 동일 API 인스턴스 안에서는 같은 키의 DB 재생성을 하나의 Promise로 합친다.
- 분산 락을 제한적으로 사용한다. Redis
SET lock:key token NX PX 3000으로 한 요청만 재생성하고 나머지는 짧게 대기하거나 오래된 값을 반환한다. - 논리적 만료를 활용한다. 물리 TTL보다 짧은 논리 만료 시점 이후에는 한 요청만 비동기 갱신하고 다른 요청에는 이전 값을 반환한다.
락은 만능 해결책이 아니다. 락 해제는 소유 토큰을 확인하는 Lua Script로 처리해야 하며 잠금 경합이 큰 키는 로컬 캐시나 사전 갱신으로 분산하는 편이 낫다.
Redis Cluster 샤딩은 어떻게 분산 처리할까?
단일 Redis 인스턴스는 메모리, CPU, 네트워크 대역폭 한계에 도달할 수 있다. Redis Cluster는 키의 CRC16 해시 슬롯 16,384개를 여러 마스터 노드에 배치해 수평 확장한다.
게임 데이터는 무작정 랜덤하게 나누기보다 접근 단위를 기준으로 키를 설계한다.
- 플레이어 단위 데이터:
player:{playerId}:profile,player:{playerId}:settings - 길드 단위 데이터:
guild:{guildId}:members - 지역 단위 데이터:
world:{regionId}:event-state - 전역 핫키: 로컬 L1 캐시 또는 복제된 읽기 모델로 분산
같은 해시 태그를 남용하면 특정 플레이어 또는 길드에 트래픽이 몰릴 때 한 슬롯과 한 노드가 뜨거워질 수 있다. 다중 키 원자 연산이 꼭 필요한 범위에만 해시 태그를 사용한다.
캐시 무효화는 어떻게 안전하게 처리할까?
캐시 무효화의 목표는 모든 응답을 즉시 최신화하는 것이 아니라 서비스가 요구하는 정합성 수준 안에서 오래된 값을 통제하는 것이다.
| 전략 | 장점 | 주의점 | 게임 서버 예시 |
|---|---|---|---|
| TTL 만료 | 구현이 간단함 | 만료 전에는 오래된 값 가능 | 게임 설정, 공지 |
| 쓰기 후 삭제 | 최신화가 빠름 | 삭제 실패 재시도 필요 | 프로필, 친구 목록 |
| 버전 키 | 배포 전환이 쉬움 | 이전 키 정리 필요 | 밸런스 데이터 |
| 이벤트 기반 삭제 | 여러 서비스 동기화 가능 | 중복·순서 뒤바뀜 처리 필요 | 길드, 상점, 소셜 데이터 |
여러 서비스가 동일 데이터를 캐싱한다면 Outbox 패턴과 메시지 브로커를 고려할 수 있다. DB 트랜잭션에서 변경 이벤트를 Outbox 테이블에 기록하고 별도 발행기가 이벤트를 전달하면 각 서비스가 멱등적으로 해당 키를 삭제한다. 이벤트 소비자는 같은 메시지가 여러 번 와도 안전하게 동작해야 한다.
운영에서 반드시 관찰할 캐시 지표는 무엇인가?
캐시 서버의 CPU 사용률만으로는 상태를 판단하기 어렵다. API와 Redis 또는 Memcached 양쪽 지표를 함께 본다.
| 지표 | 확인할 문제 | 권장 대응 |
|---|---|---|
| Cache hit ratio | 낮은 적중률, 잘못된 TTL | 키별 요청량과 TTL 재검토 |
| P95/P99 캐시 지연 | 네트워크·CPU 포화 | 커넥션 풀, 노드 규모, 핫키 확인 |
| Eviction 수 | 메모리 부족 또는 TTL 과다 | 메모리 증설, 키 크기·정책 점검 |
| DB fallback 비율 | 캐시 장애·만료 폭주 | 스탬피드 방지, 장애 알림 |
| 키별 QPS | 핫키 집중 | L1 캐시, 키 분할, 사전 갱신 |
| Redis replication lag | 복제본 읽기의 최신성 저하 | 읽기 일관성 정책 조정 |
적중률은 다음처럼 계산한다.
전체 적중률이 높아도 로그인이나 결제 직후처럼 중요한 경로의 미스가 많을 수 있다. API와 키 접두사별로 분리해 관찰하는 것이 중요하다.
자주 묻는 질문 (FAQ)
Redis를 쓰면 DB 없이 게임 데이터를 운영해도 될까?
아니다. Redis는 매우 빠르지만 메모리 압박, 설정 실수, 장애, 복구 정책의 영향을 받는다. 유료 재화와 인벤토리처럼 손실이 허용되지 않는 데이터는 DB 트랜잭션 또는 내구성 있는 이벤트 로그를 원본으로 유지해야 한다.
캐시 TTL은 길게 설정할수록 좋은가?
아니다. TTL이 길면 DB 부하는 줄지만 오래된 데이터가 보이는 시간이 길어진다. 데이터별 변경 빈도와 허용 가능한 지연을 기준으로 정하고 변경 직후 삭제가 필요한 데이터에는 TTL만 의존하지 않는다.
Redis 복제본에서 읽으면 항상 안전한가?
아니다. 복제는 비동기이므로 마스터에 기록한 값이 복제본에 아직 반영되지 않았을 수 있다. 재화 변경 직후처럼 읽기 일관성이 필요한 경로는 마스터 읽기나 DB 원본 조회를 선택한다.
정리
게임 서버 캐시는 DB를 대체하는 저장소가 아니라 읽기 부하와 응답 지연을 줄이는 계층이다. 먼저 Cache-Aside, 데이터별 TTL, 쓰기 후 삭제를 안정적으로 적용하고 트래픽이 커질 때 캐시 스탬피드 방지와 Redis Cluster 샤딩을 추가하는 순서가 현실적이다. 마지막으로 캐시 적중률뿐 아니라 축출, 핫키, DB 폴백, P99 지연을 함께 모니터링해야 분산 캐시가 실제 운영 안정성으로 이어진다.