Jenkins 빌드 실패 로그 실시간 AI 분석과 Slack 해결 가이드 자동 전송
Jenkins 빌드 실패 로그를 웹훅으로 수집하고 AI가 원인·증거·해결 단계를 구조화해 Slack으로 실시간 전송하는 방법을 다룹니다. 로그 마스킹, 신뢰도 기준, 자동 재시도 안전장치와 운영 체크리스트까지 함께 정리합니다.
핵심 요약
Jenkins의 post { failure { ... } } 단계에서 실패 로그를 분석 API로 전송하고 로그 정제·비밀정보 마스킹 후 AI가 원인 분류와 해결 조치를 구조화하면 Slack에 즉시 공유할 수 있습니다. AI 출력은 category, summary, evidence, remediation, confidence, auto_action 같은 고정 필드로 제한하고 자동 재실행은 신뢰도와 허용 목록을 통과한 경우에만 실행해야 안전합니다.
Jenkins 빌드 실패 로그 AI 분석은 왜 필요한가?
Jenkins 빌드가 실패하면 개발자는 콘솔 로그를 열고 긴 출력에서 최초 오류를 찾은 뒤 담당 팀과 해결 방법을 공유해야 합니다. 컴파일 오류, 단위 테스트 실패, 패키지 다운로드 오류, 에이전트 디스크 부족처럼 원인이 반복되는 경우에도 확인 절차가 매번 수동으로 진행됩니다.
AI 분석을 추가하면 빌드 실패 직후 다음 정보를 한 번에 제공할 수 있습니다.
| 정보 | 예시 |
|---|---|
| 원인 분류 | compile, test, dependency, infra, unknown |
| 근거 로그 | 실패를 직접 증명하는 로그 1~3줄 |
| 해결 단계 | 명령어, 설정 파일, 담당 팀 확인 순서 |
| 신뢰도 | 0.0부터 1.0까지의 분석 확신도 |
| 자동 조치 | none, rerun, owner_notify |
Jenkins에 AI 호출 로직을 모두 넣을 필요는 없습니다. Jenkins는 실패 이벤트와 필요한 로그만 전달하고, 별도의 분석 API가 로그 정제부터 AI 분석과 Slack 전송까지 맡으면 타임아웃과 보안 문제를 줄일 수 있습니다.
전체 처리 흐름은 어떻게 설계할까?
권장 구성은 Jenkins Pipeline, 분석 API, AI Gateway, Slack Incoming Webhook의 네 계층입니다. 운영 규모가 커지면 분석 API 앞에 Redis Queue, Amazon SQS, RabbitMQ 같은 작업 큐를 추가합니다.
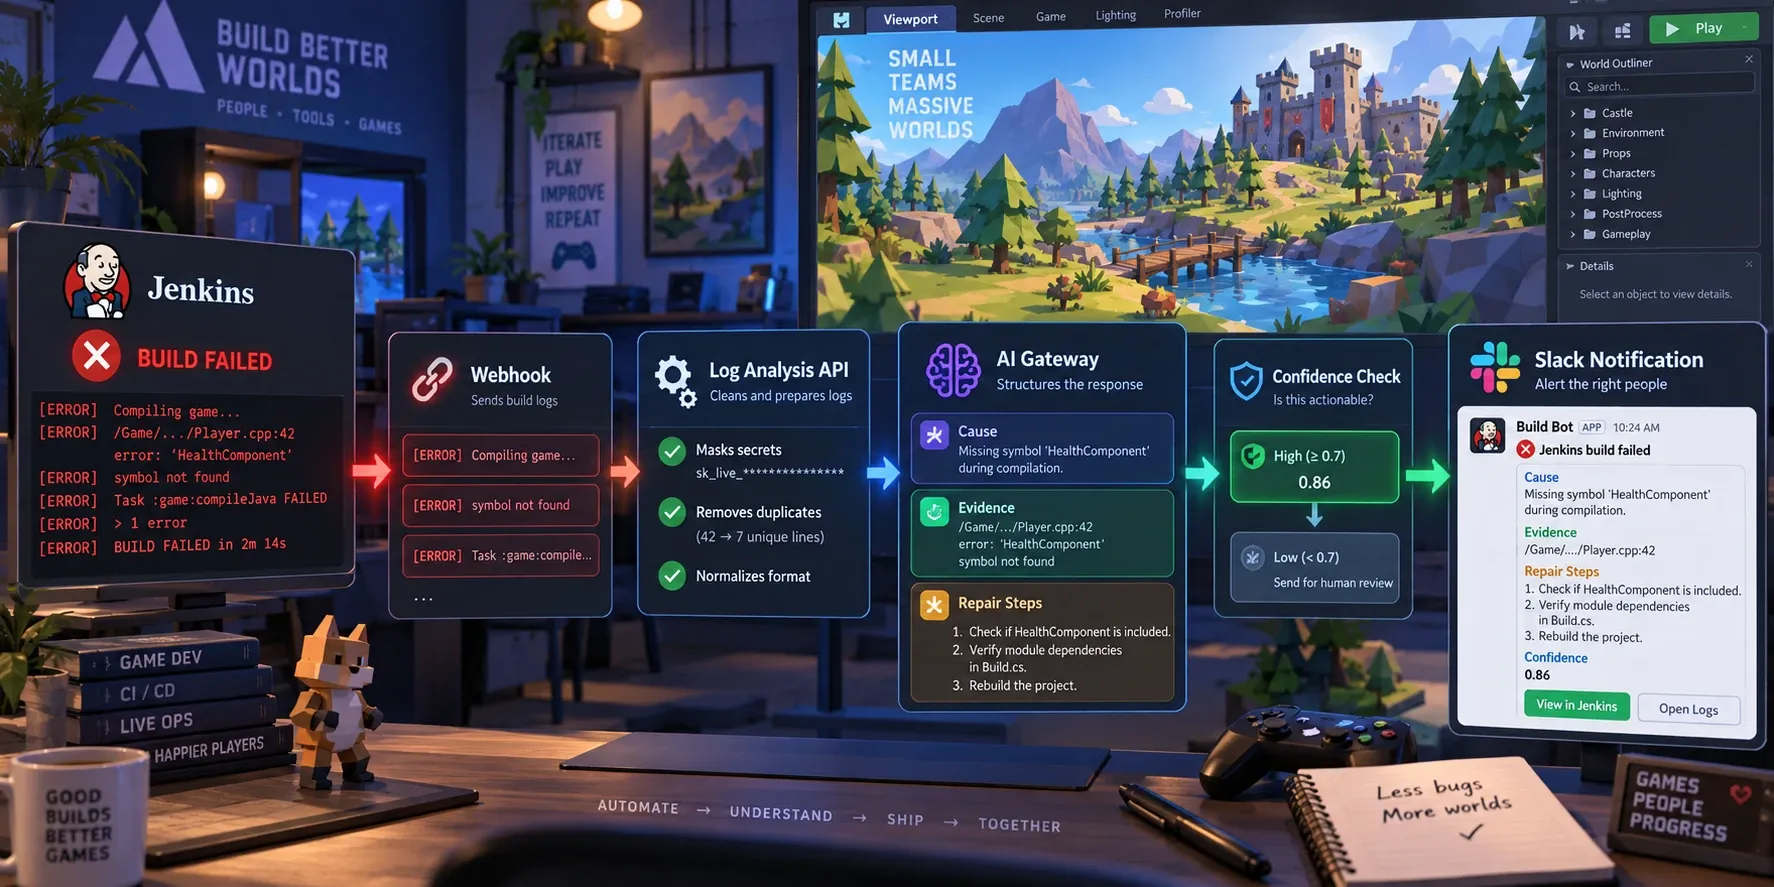
flowchart LR
    A[Jenkins Pipeline] -->|실패 이벤트| B[분석 API]
    B --> C[로그 정제 및 비밀정보 제거]
    C --> D[AI 구조화 분석]
    D --> E{정책 검증}
    E -->|허용되지 않음| F[Slack 알림]
    E -->|허용됨| G[제한된 자동 조치]
    G --> F
처리 단계는 다음과 같습니다.
- Jenkins가 실패한 Job, Build Number, Git Commit, 콘솔 로그 일부를 전송합니다.
- 분석 API가 ANSI 색상 코드, 중복 라인, 토큰과 비밀번호를 제거합니다.
- AI Gateway가 정해진 JSON 스키마로 원인과 해결 단계를 반환합니다.
- 서버가 신뢰도, 중복 전송 여부, 자동 조치 허용 여부를 검증합니다.
- Slack에 요약, 근거 로그, 해결 가이드, Jenkins 링크를 전송합니다.
1단계: Jenkins 실패 훅에서 로그를 어떻게 보낼까?
Jenkins Pipeline의 post { failure { ... } } 블록은 스테이지 실패뿐 아니라 전체 Pipeline 실패 시점에 실행할 수 있습니다. 아래 예시는 HTTP Request Plugin을 사용해 마지막 400줄을 분석 API로 보내는 Jenkinsfile입니다.
pipeline {
    agent any

    stages {
        stage('Build') {
            steps {
                sh './gradlew build'
            }
        }
    }

    post {
        failure {
            script {
                // rawBuild.getLog 사용에는 Jenkins Script Approval이 필요할 수 있습니다.
                def logTail = currentBuild.rawBuild.getLog(400).join('\\n')
                def payload = groovy.json.JsonOutput.toJson([
                    job: env.JOB_NAME,
                    build: env.BUILD_NUMBER,
                    result: currentBuild.currentResult,
                    commit: env.GIT_COMMIT ?: 'unknown',
                    url: env.BUILD_URL,
                    log_tail: logTail
                ])

                withCredentials([
                    string(credentialsId: 'jenkins-ai-token', variable: 'AI_TOKEN')
                ]) {
                    httpRequest(
                        httpMode: 'POST',
                        url: 'https://ci-tools.example.com/hooks/jenkins',
                        contentType: 'APPLICATION_JSON',
                        customHeaders: [[
                            name: 'Authorization',
                            value: 'Bearer ' + AI_TOKEN
                        ]],
                        requestBody: payload,
                        validResponseCodes: '200:299',
                        timeout: 30
                    )
                }
            }
        }
    }
}
전체 콘솔 로그를 그대로 보내면 토큰, 경로, 내부 URL, 테스트 계정 정보가 유출될 수 있습니다. 기본값은 마지막 로그 일부로 제한하고 실제 서비스에서는 실패가 처음 발생한 구간과 예외 스택 트레이스를 별도로 추출하는 방식이 좋습니다.
currentBuild.rawBuild.getLog()가 Script Approval을 요구하는 환경에서는 Jenkins 플러그인으로 콘솔 로그를 수집하거나 분석 API가 Jenkins 인증 정보를 사용해 consoleText REST API를 조회하도록 분리할 수 있습니다. 이때 Jenkins 자격 증명은 읽기 전용 권한만 부여해야 합니다.
2단계: 분석 API에서 로그를 어떻게 정제하고 AI에 전달할까?
분석 API는 Python 3.11 이상, FastAPI, Pydantic v2 조합으로 간단히 만들 수 있습니다. 중요한 원칙은 AI가 자유로운 문장을 반환하지 않고 고정된 스키마를 반환하게 하는 것입니다.
from typing import Literal
import hashlib
import hmac
import os
import re

import requests
from fastapi import BackgroundTasks, FastAPI, Header, HTTPException
from pydantic import BaseModel

app = FastAPI()


class Failure(BaseModel):
    job: str
    build: str
    result: str
    commit: str
    url: str
    log_tail: str


class Diagnosis(BaseModel):
    category: Literal['compile', 'test', 'dependency', 'infra', 'unknown']
    summary: str
    evidence: list[str]
    remediation: list[str]
    confidence: float
    auto_action: Literal['none', 'rerun', 'owner_notify']


def redact(text: str) -> str:
    text = re.sub(
        r'(?i)(authorization:\s*bearer\s+)[^\s]+',
        r'\1[REDACTED]',
        text,
    )
    text = re.sub(
        r'(?i)(password|token|api[_-]?key)\s*[=:]\s*[^\s]+',
        r'\1=[REDACTED]',
        text,
    )
    text = '\n'.join(
        line.replace('\x1b', '')
        for line in text.splitlines()
    )
    return text[-12000:]


def analyze_with_gateway(prompt: str) -> Diagnosis:
    response = requests.post(
        os.environ['AI_GATEWAY_URL'],
        json={
            'task': 'jenkins-failure-analysis',
            'prompt': prompt,
            'response_schema': Diagnosis.model_json_schema(),
        },
        timeout=25,
    )
    response.raise_for_status()
    return Diagnosis.model_validate(response.json())


def send_slack(failure: Failure, diagnosis: Diagnosis) -> None:
    evidence = '\\n'.join(
        '- ' + item for item in diagnosis.evidence[:3]
    )
    actions = '\\n'.join(
        str(index + 1) + '. ' + item
        for index, item in enumerate(diagnosis.remediation[:5])
    )
    blocks = [
        {
            'type': 'header',
            'text': {
                'type': 'plain_text',
                'text': f'빌드 실패: {failure.job} #{failure.build}',
            },
        },
        {
            'type': 'section',
            'text': {
                'type': 'mrkdwn',
                'text': (
                    f'*분류*: `{diagnosis.category}`\\n'
                    f'*신뢰도*: `{diagnosis.confidence:.2f}`\\n'
                    f'*요약*: {diagnosis.summary}\\n\\n'
                    f'*근거 로그*\\n{evidence}\\n\\n'
                    f'*해결 가이드*\\n{actions}\\n'
                    f'<{failure.url}|Jenkins 빌드 열기>'
                ),
            },
        },
    ]
    response = requests.post(
        os.environ['SLACK_WEBHOOK_URL'],
        json={'blocks': blocks},
        timeout=10,
    )
    response.raise_for_status()


def process_failure(failure: Failure) -> None:
    clean_log = redact(failure.log_tail)
    prompt = f'''
You are a Jenkins build failure analyst.
Use only the supplied log. Do not invent a cause or claim that a command was executed.
Return JSON matching the provided schema.
Evidence must contain up to three short exact log excerpts.
Set auto_action to rerun only for a likely transient infrastructure failure.

Job: {failure.job}
Build: {failure.build}
Commit: {failure.commit}
Log:
{clean_log}
'''
    diagnosis = analyze_with_gateway(prompt)
    send_slack(failure, diagnosis)


@app.post('/hooks/jenkins')
def receive_failure(
    failure: Failure,
    background_tasks: BackgroundTasks,
    authorization: str | None = Header(default=None),
):
    expected = 'Bearer ' + os.environ['JENKINS_AI_TOKEN']
    if not authorization or not hmac.compare_digest(authorization, expected):
        raise HTTPException(status_code=401, detail='unauthorized')

    background_tasks.add_task(process_failure, failure)
    return {'accepted': True, 'job': failure.job, 'build': failure.build}
위 코드는 이해를 위한 최소 구현입니다. 트래픽이 많거나 분석이 오래 걸리는 환경에서는 BackgroundTasks 대신 내구성 있는 큐를 사용해야 합니다. API는 먼저 202 Accepted를 반환하고 워커가 AI 분석과 Slack 전송을 수행하면 Jenkins Pipeline이 AI 응답 때문에 길게 대기하지 않습니다.
AI Gateway 프롬프트에는 다음 제약을 명시하는 것이 좋습니다.
- 제공된 로그만 근거로 사용하고 원인을 추정한 경우
unknown으로 분류한다. evidence에는 실제 로그에 존재하는 짧은 문장만 넣는다.confidence는 0.0부터 1.0 사이의 숫자로 반환한다.- 해결 단계는 실행 명령어 또는 변경 파일을 구체적으로 작성한다.
auto_action은 허용된 열거값 외에 반환하지 않는다.
3단계: Slack 알림에는 무엇을 포함해야 할까?
실패 로그 전체를 Slack에 붙이면 메시지가 읽기 어렵고 Slack 메시지 길이 제한에도 걸릴 수 있습니다. 알림에는 판단에 필요한 정보만 넣고 Jenkins 원문 링크를 함께 제공해야 합니다.
| Slack 필드 | 포함할 내용 | 목적 |
|---|---|---|
| 제목 | Job 이름과 Build Number | 실패 대상을 즉시 식별 |
| 분류 | 컴파일, 테스트, 의존성, 인프라 | 담당 팀 라우팅 |
| 요약 | 한두 문장의 원인 설명 | 빠른 판단 |
| 근거 | 실제 로그 1~3줄 | AI 환각 검증 |
| 해결 가이드 | 우선순위가 있는 3~5단계 | 조치 실행 |
| 링크 | Jenkins Build URL | 원문과 아티팩트 확인 |
같은 Job의 재시도나 후속 분석은 Slack 스레드로 묶고 메시지 본문에는 job + build + commit을 함께 기록하면 중복 알림을 찾기 쉽습니다. 서버에는 job, build, log_hash를 조합한 idempotency key를 저장해 같은 이벤트가 여러 번 전송되어도 Slack 메시지가 중복 생성되지 않게 합니다.
자동 해결 조치는 어디까지 허용해야 할까?
AI는 원인을 설명하는 데 유용하지만 운영 환경을 직접 변경하는 권한을 가져서는 안 됩니다. 자동 조치는 명시적인 허용 목록과 실행 횟수 제한을 통과한 경우에만 수행합니다.
| 자동 조치 | 허용 조건 | 안전장치 |
|---|---|---|
| 동일 빌드 재실행 | infra 분류, 신뢰도 0.9 이상 | Build당 1회, 수동 승인 또는 라벨 필요 |
| 담당자 알림 | 분류와 무관하게 실패 발생 | Slack 멘션 목록을 서버 설정으로 관리 |
| 의존성 버전 변경 | 자동 실행 금지 | PR 생성 후 리뷰와 CI 재검증 |
| 배포 롤백 | 자동 실행 금지에 가깝게 운영 | 별도 런북과 승인 절차 사용 |
예를 들어 네트워크 타임아웃이나 에이전트 연결 끊김은 재시도 가치가 있지만 컴파일 오류나 테스트 실패는 재실행해도 해결되지 않을 가능성이 높습니다. AI의 auto_action만 믿지 말고 서버 정책에서 다시 검증해야 합니다.
운영 환경에 적용하는 순서는 무엇일까?
1. Jenkins 자격 증명과 로그 범위를 설정한다
Jenkins에는 분석 API 호출용 Secret Text 자격 증명을 등록합니다. 로그는 최근 400~800줄부터 시작하고 대형 스택 트레이스는 길이 제한을 둡니다. 운영 로그에 포함될 수 있는 비밀번호, 토큰, 쿠키, 서명 값은 정규식과 키 이름 기반으로 모두 마스킹합니다.
2. 분석 API와 AI Gateway를 분리한다
분석 API에는 인증, 입력 검증, 로그 정제, 중복 제거, Slack 전송을 둡니다. 모델 공급자를 교체할 수 있도록 AI 호출은 analyze_with_gateway() 같은 어댑터 뒤에 숨깁니다. 모델이 바뀌어도 Jenkins와 Slack 연동 계약은 유지됩니다.
3. Slack Incoming Webhook을 제한한다
Slack Webhook URL은 소스 저장소나 Jenkins 로그에 노출하지 않고 Secret Manager 또는 Jenkins Credentials에 저장합니다. 채널은 빌드 실패 전용으로 분리하고 서비스 계정이 불필요한 채널에 메시지를 작성하지 못하도록 관리합니다.
4. 의도적인 실패로 검증한다
테스트 Pipeline에서 다음과 같이 실패를 발생시킨 뒤 전체 경로를 확인합니다.
stage('AI Alert Test') {
    steps {
        sh 'exit 1'
    }
}
검증 항목은 HTTP 응답 코드, 분석 API의 인증 실패 처리, 비밀정보 마스킹, AI 응답 스키마 검증, Slack 메시지 도착, 중복 이벤트 차단, Jenkins 링크의 접근 권한입니다.
분석 품질과 실시간성을 어떻게 측정할까?
실시간 알림은 단순히 AI를 호출하는 것보다 이벤트부터 Slack 도착까지의 지연과 실패율을 측정하는 것이 중요합니다. 다음 지표를 서버 로그와 메트릭으로 기록합니다.
webhook_accept_latency: Jenkins 이벤트 수신 시간ai_latency: AI Gateway 응답 시간slack_delivery_latency: Slack 전송 완료까지의 시간analysis_failure_rate: AI 또는 Slack 호출 실패 비율category_accuracy: 사람이 검토한 원인 분류 정확도duplicate_suppression_count: 중복 알림 차단 횟수auto_action_rate: 자동 조치가 실행된 빌드 비율
알림 지연은 다음과 같이 계산할 수 있습니다.
초기에는 unknown 분류 비율과 잘못된 자동 조치 비율을 우선 확인합니다. 정확도를 높이려면 사람이 수정한 분류와 실제 해결 방법을 저장해 이후 프롬프트와 규칙 평가에 활용할 수 있습니다.
자주 묻는 질문 (FAQ)
Jenkins에서 직접 AI API를 호출하면 안 되나요?
가능하지만 권장하지 않습니다. Jenkins는 빌드 실행에 집중하고 분석 API가 인증, 로그 정제, 재시도, Slack 전송을 담당하도록 분리하면 Pipeline 타임아웃과 자격 증명 노출 위험을 줄일 수 있습니다.
전체 콘솔 로그를 AI에 보내야 하나요?
아닙니다. 마지막 로그 일부와 최초 오류 주변의 문맥만 보내는 것이 기본입니다. 필요할 때만 읽기 전용 Jenkins API로 추가 로그를 조회하고 모든 입력을 마스킹해야 합니다.
AI가 분석하면 자동으로 빌드를 재실행해도 되나요?
제한적으로만 허용해야 합니다. 인프라성 일시 오류, 높은 신뢰도, Build당 1회 제한, 허용 목록 검사를 모두 통과한 경우에만 재실행하고 코드·의존성·배포 변경은 자동 실행하지 않는 편이 안전합니다.
정리
Jenkins 실패 로그 실시간 AI 분석의 핵심은 모델 자체가 아니라 안정적인 이벤트 계약과 운영 안전장치입니다. post { failure { ... } }로 실패를 감지하고 FastAPI 분석 API에서 로그를 정제한 뒤 고정 JSON 스키마로 AI 결과를 받아 Slack에 요약을 전송하면 개발자는 긴 콘솔 로그를 처음부터 읽지 않고도 다음 조치를 빠르게 결정할 수 있습니다.
자동화 범위는 설명과 알림에서 시작하고 재실행은 명확한 정책과 감사 로그가 마련된 뒤 단계적으로 확대하는 것이 좋습니다.