Jira 백로그 유저 스토리로 기획 명세서와 인수 조건을 AI로 자동 생성하는 방법
Jira 백로그의 유저 스토리를 기획 명세서와 인수 조건으로 변환하는 AI 워크플로를 설계하고 구조화 출력, 검증, 리뷰 기준까지 실무 관점에서 정리합니다.
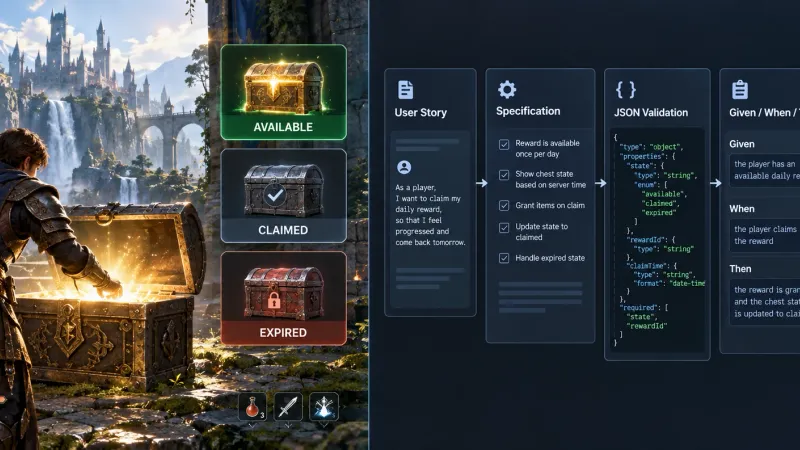
핵심 요약
Jira 백로그의 유저 스토리는 개발 방향을 설명하지만 화면 상태, 예외 흐름, 데이터 규칙, 완료 판정까지 담기에는 부족한 경우가 많습니다. Jira Cloud REST API v3에서 이슈 정보를 가져온 뒤 AI에 JSON Schema 기반 출력을 요구하면 기획 명세서와 인수 조건(AC)을 일정한 형식으로 자동 초안화할 수 있습니다.
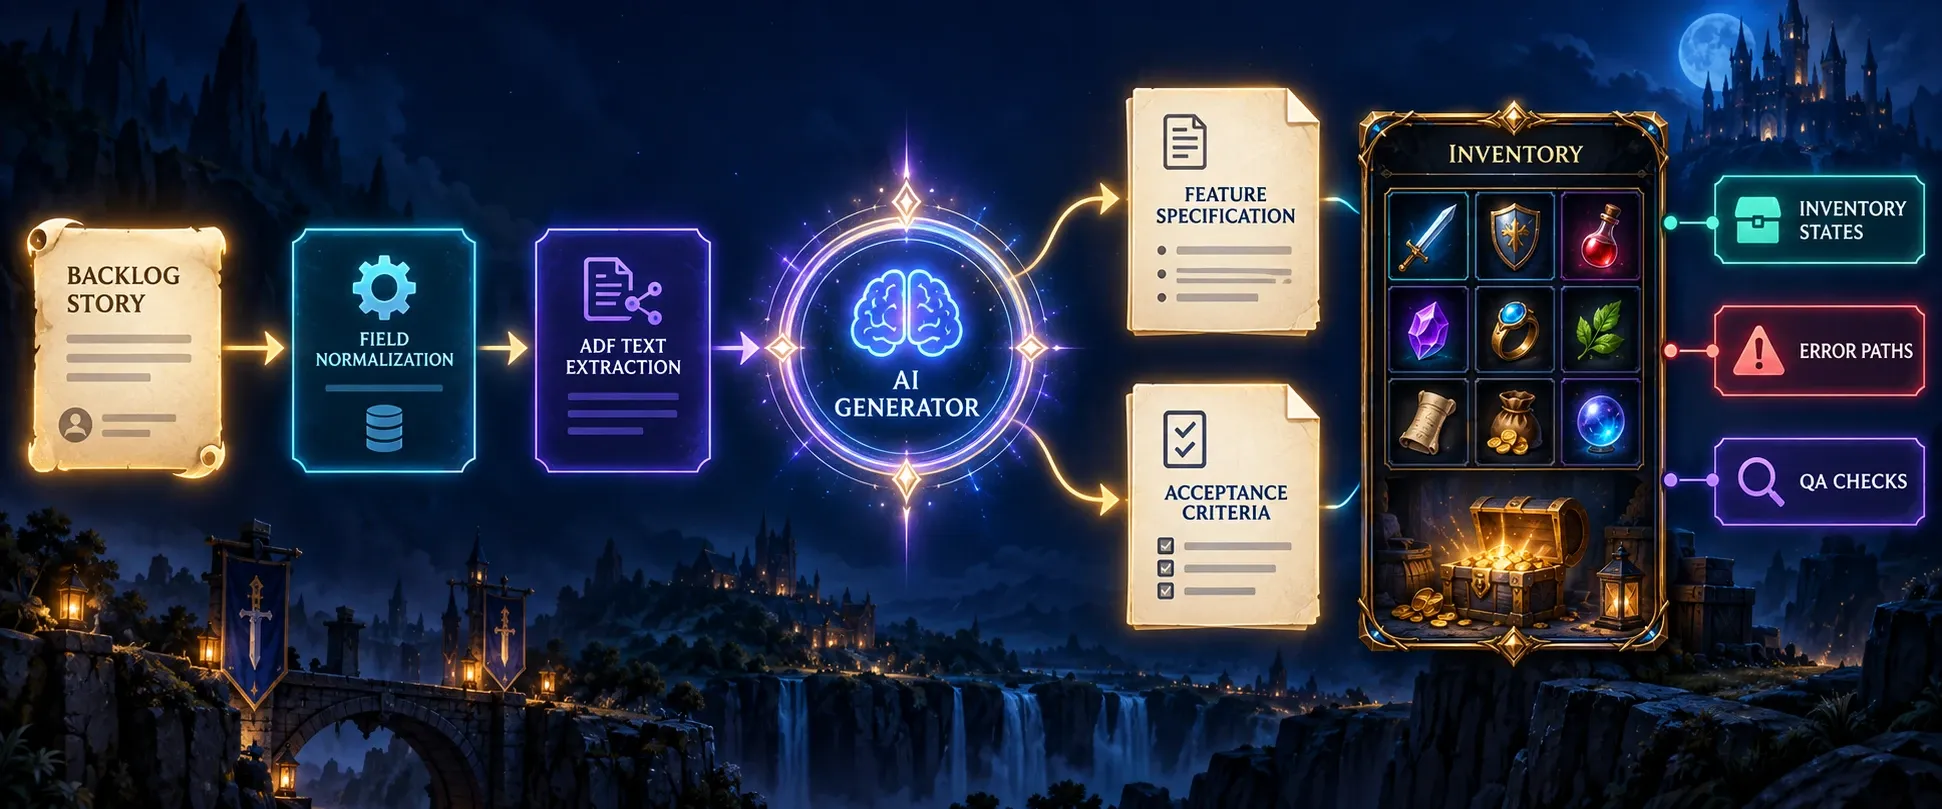
핵심은 AI가 최종 승인자가 되도록 만드는 것이 아니라 수집 → 구조화 생성 → 규칙 검증 → 기획·개발 리뷰 → Jira 반영의 파이프라인으로 사용하는 것입니다. 생성 결과에는 반드시 원문 근거, 미확정 항목, 예외 조건을 분리해 사람이 빠르게 검토할 수 있게 해야 합니다.
왜 Jira 유저 스토리만으로는 개발을 시작하기 어려운가?
유저 스토리는 보통 다음 형식을 사용합니다.
As a player, I want to claim a daily reward so that I can receive a reason to return every day.
이 문장은 기능의 목적은 전달하지만 다음 질문에는 답하지 않습니다.
| 확인해야 할 항목 | 유저 스토리에서 자주 빠지는 내용 |
|---|---|
| 진입점 | 어느 메뉴와 버튼에서 보상 화면을 여는가? |
| 상태 | 수령 가능, 수령 완료, 기간 만료 상태를 어떻게 구분하는가? |
| 규칙 | 일일 초기화 기준 시간대와 연속 출석 계산 방식은 무엇인가? |
| 예외 | 네트워크 오류, 인벤토리 가득 참, 중복 요청은 어떻게 처리하는가? |
| 데이터 | 보상 아이템 ID, 수량, 지급 로그를 어디에 저장하는가? |
| 완료 판정 | QA와 개발자가 어떤 조건을 만족하면 완료로 판단하는가? |
특히 게임 기능은 UI 상태와 게임 규칙이 강하게 연결됩니다. AI에게 유저 스토리 한 줄만 전달하면 그럴듯하지만 팀의 합의와 다른 세부사항을 만들어낼 위험이 있습니다.
AI 자동 생성의 기본 구조는 어떻게 설계할까?
권장 입력은 유저 스토리 본문 하나가 아니라 Jira 이슈의 업무 맥락을 포함한 정규화 객체입니다.
{
  "issueKey": "GAME-142",
  "summary": "플레이어가 일일 보상을 수령할 수 있다",
  "description": "플레이어는 하루에 한 번 출석 보상을 수령한다.",
  "priority": "High",
  "labels": ["live-service", "economy"],
  "components": ["Lobby", "Inventory"],
  "existingDecisions": [
    "일일 초기화 기준은 UTC 00:00이다",
    "보상 지급은 서버에서 처리한다"
  ]
}
생성기는 이 입력을 다음 결과로 변환합니다.
- 기능 목적과 범위
- 사용자 흐름과 화면 상태
- 게임 규칙 및 데이터 요구사항
- 예외·실패 처리
- 의존성·미확정 항목
- 테스트 가능한 인수 조건
- Definition of Done 체크리스트
Jira에서 어떤 데이터를 가져와야 하는가?
Jira Cloud REST API v3의 이슈 조회 엔드포인트를 사용할 때는 필요한 필드만 지정하는 편이 좋습니다. 설명 필드가 Atlassian Document Format(ADF)으로 반환되는 프로젝트라면 텍스트 추출 단계를 별도로 둡니다.
GET https://your-domain.atlassian.net/rest/api/3/issue/GAME-142?fields=summary,description,priority,labels,components,parent,issuelinks
Authorization: Basic <base64(email:api_token)>
Accept: application/json
실제 운영에서는 다음 원칙을 지키는 것이 안전합니다.
- API 토큰은 환경 변수나 시크릿 매니저에 저장한다.
- 생성에 필요하지 않은 댓글과 개인정보는 전달하지 않는다.
- Jira 이슈 키와 조회 시각을 결과 메타데이터에 남긴다.
- 원문과 AI 생성문을 구분해 추적 가능성을 확보한다.
- 팀이 합의한 커스텀 필드만 허용 목록으로 전달한다.
ADF 설명을 어떻게 일반 텍스트로 정규화할까?
ADF는 type, content, text가 중첩된 JSON 문서입니다. 모델에 원본 JSON 전체를 그대로 전달하기보다 문단·목록·표의 의미를 보존한 텍스트로 변환하는 편이 토큰과 해석 오류를 줄입니다.
type AdfNode = {
  type?: string;
  text?: string;
  content?: AdfNode[];
};

export function adfToText(node: AdfNode | undefined): string {
  if (!node) return '';

  const ownText = node.text ?? '';
  const childText = (node.content ?? [])
    .map(adfToText)
    .filter(Boolean)
    .join(node.type === 'paragraph' ? '' : ' ');

  const value = `${ownText}${childText}`.trim();
  if (!value) return '';

  if (node.type === 'listItem') return `- ${value}`;
  return value;
}
프로젝트에 표, 링크, 멘션, 코드 블록이 많이 사용된다면 단순 텍스트 변환만으로 의미가 손실될 수 있습니다. 이 경우 table, media, mention 같은 ADF 노드에 대한 변환 규칙을 명시하고 원문 링크를 함께 보관해야 합니다.
어떤 프롬프트가 기획 명세서와 AC를 안정적으로 만드는가?
좋은 프롬프트는 “자세히 작성하라”보다 출력 스키마, 근거 범위, 불확실성 처리 규칙을 먼저 정의합니다.
역할: 게임 개발팀의 시니어 프로덕트 매니저

목표:
Jira 유저 스토리를 개발·QA 리뷰가 가능한 기획 명세서 초안으로 변환한다.

규칙:
1. 입력에 없는 게임 규칙, 수치, 일정, 보상, UI 문구를 사실처럼 확정하지 않는다.
2. 추론이 필요한 내용은 assumptions에 기록한다.
3. 결정되지 않은 내용은 openQuestions에 기록한다.
4. 모든 acceptanceCriteria는 Given-When-Then 형식으로 작성한다.
5. 각 acceptanceCriteria에는 검증 가능한 expectedResult를 포함한다.
6. 같은 조건을 여러 AC에 중복 작성하지 않는다.
7. 플레이어 경험과 서버 권위 검증을 분리한다.
8. 기존 결정사항과 충돌하면 conflict 항목에 기록한다.

입력:
{{normalizedJiraIssue}}

출력:
정해진 JSON Schema에 맞는 JSON만 반환한다.
여기서 중요한 부분은 assumptions와 openQuestions입니다. AI가 빈칸을 임의로 채우지 않고 불확실성을 표면화하면 기획 회의에서 확인해야 할 의제가 바로 보입니다.
인수 조건은 왜 Given-When-Then으로 작성하는가?
인수 조건은 기능 설명이 아니라 완료 여부를 확인하는 테스트 기준이어야 합니다. 다음과 같이 조건, 행동, 기대 결과를 분리하면 기획·개발·QA가 같은 문장을 기준으로 대화할 수 있습니다.
Feature: 일일 보상 수령

  Scenario: 오늘 보상을 아직 받지 않은 플레이어가 수령한다
    Given 플레이어가 오늘 보상을 수령하지 않았고
    And 서버 시간이 일일 보상 수령 가능 시간 안에 있을 때
    When 플레이어가 보상 수령 버튼을 선택하면
    Then 서버는 보상 지급을 1회 처리하고
    And 인벤토리에 보상 아이템을 추가하며
    And 화면은 수령 완료 상태로 변경한다
게임 기능에서는 클라이언트 화면만 바뀌었다고 성공으로 판정하면 안 됩니다. 보상, 재화, 스탯처럼 조작 위험이 있는 값은 서버 권위 로직과 중복 요청 방지까지 AC에 포함해야 합니다.
AI 출력 JSON Schema는 어떻게 정의할까?
구조화 출력은 생성 결과를 Jira 커스텀 필드, Markdown, 테스트 케이스 템플릿으로 재사용하게 해줍니다. 핵심 스키마는 다음처럼 정의할 수 있습니다.
{
  "type": "object",
  "required": ["source", "scope", "functionalSpec", "acceptanceCriteria", "assumptions", "openQuestions"],
  "properties": {
    "source": { "type": "object" },
    "scope": { "type": "object" },
    "functionalSpec": { "type": "object" },
    "acceptanceCriteria": {
      "type": "array",
      "items": {
        "type": "object",
        "required": ["id", "given", "when", "then", "expectedResult"]
      }
    },
    "assumptions": { "type": "array", "items": { "type": "string" } },
    "openQuestions": { "type": "array", "items": { "type": "string" } }
  },
  "additionalProperties": false
}
스키마 검증은 AI 호출 직후에 수행합니다. 검증에 실패하면 결과를 Jira에 쓰지 말고 재생성하거나 사람 검토 큐로 보냅니다. 스키마가 유효하다는 사실만으로 내용이 옳다는 뜻은 아니므로 비즈니스 규칙 검증을 별도로 추가해야 합니다.
Jira 백로그에서 자동 생성하는 절차는 무엇인가?
1단계: 생성 대상과 승인 경계를 정한다
먼저 어떤 이슈를 자동화할지 정합니다.
| 대상 | 권장 자동화 수준 | 이유 |
|---|---|---|
| Story, Task | 초안 자동 생성 | 요구사항을 구조화하기 좋음 |
| Bug | 재현 절차·검증 항목 초안 | 원인 추정은 제한해야 함 |
| Epic | 범위·하위 작업 제안 | 전체 기획 확정으로 오해하지 않도록 함 |
| Change Request | 영향 범위 분석 초안 | 일정·비용 판단은 사람 승인 필요 |
생성 결과를 바로 Done으로 전환하거나 배포 조건으로 사용하는 것은 피합니다. 기본 상태는 AI Draft 또는 Spec Review로 두고 담당 기획자와 개발 리드의 승인을 요구하는 편이 좋습니다.
2단계: Jira 이슈를 정규화하고 컨텍스트를 보강한다
이슈마다 필드가 비어 있으면 결과 품질도 흔들립니다. 다음 최소 필드를 팀 템플릿으로 고정하면 입력 품질이 올라갑니다.
- 사용자 또는 플레이어 유형
- 원하는 행동
- 행동의 목적
- 기능 범위
- 관련 화면·시스템
- 우선순위와 릴리스 목표
- 이미 결정된 규칙
- 제외 범위
여러 이슈가 같은 기능을 다룬다면 부모 Epic, 연결된 이슈, 최근 승인된 기획 문서만 선택적으로 가져옵니다. 관련 없는 전체 프로젝트를 프롬프트에 넣으면 비용과 혼선이 함께 커집니다.
3단계: 생성·검증·리뷰 결과를 Jira에 반영한다
권장 상태 전이는 다음과 같습니다.
flowchart LR
    A[Jira Story] --> B[필드 정규화]
    B --> C[AI 구조화 생성]
    C --> D{JSON Schema 및 규칙 검증}
    D -- 실패 --> E[재생성 또는 검토 큐]
    D -- 통과 --> F[기획·개발 리뷰]
    F -- 수정 필요 --> C
    F -- 승인 --> G[Jira 설명·AC 필드 반영]
Jira에 반영할 때는 기존 설명을 덮어쓰기보다 다음 중 하나를 선택합니다.
- 별도 커스텀 필드에
AI Spec Draft저장 - Jira 설명 하단에 자동 생성 섹션 추가
- 외부 문서에 저장하고 이슈에 버전 링크 연결
- 승인된 경우에만 기존 명세서 영역 업데이트
자동 생성 시각, 사용한 모델 식별자, 프롬프트 버전, 입력 이슈의 수정 시각을 기록하면 결과가 바뀌었을 때 원인을 추적하기 쉽습니다.
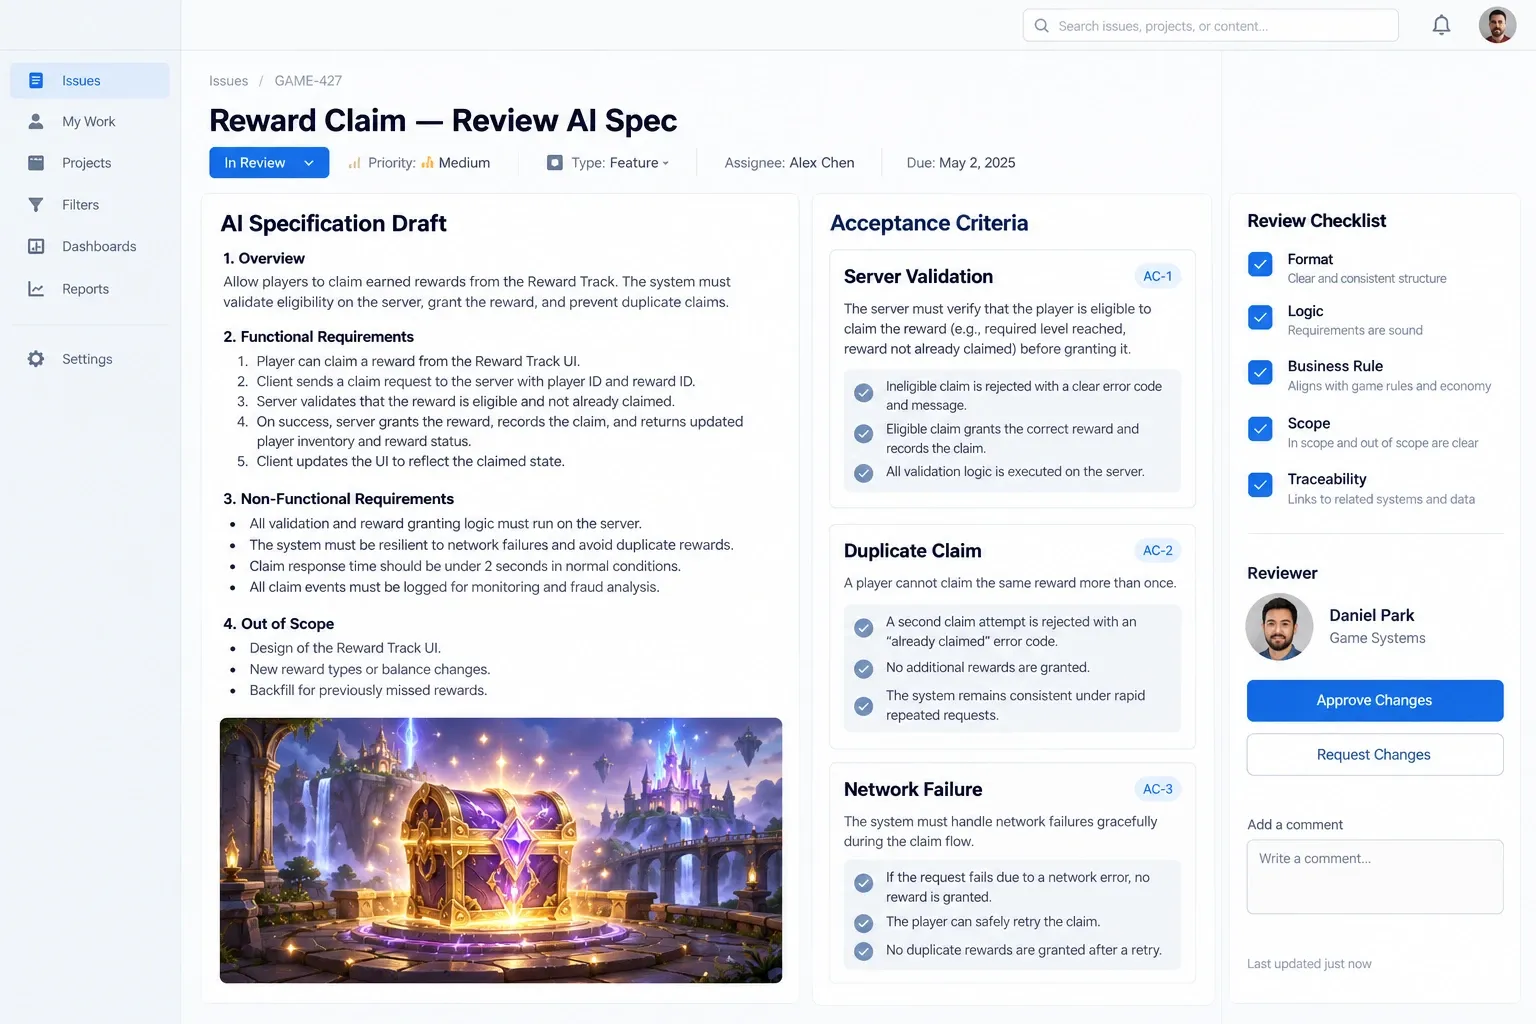
자동 생성 결과를 어떻게 검증해야 하는가?
검증은 형식, 논리, 업무 규칙의 세 층으로 나누는 것이 좋습니다.
| 검증 층 | 검사 예시 | 실패 시 조치 |
|---|---|---|
| 형식 검증 | 필수 키, 타입, AC ID 패턴 | 자동 재생성 또는 큐 이동 |
| 논리 검증 | Given-When-Then 누락, 모순된 상태 | 리뷰 요청 |
| 업무 규칙 검증 | 서버 권위, 재화 중복 지급, 권한 검사 | 개발 리드 확인 |
| 범위 검증 | Epic 범위를 벗어난 기능 추가 | 범위 축소 후 재생성 |
| 추적성 검증 | 원문에 없는 사실의 확정 | assumptions로 이동 |
다음과 같은 자동 규칙을 추가하면 게임 프로젝트에서 자주 발생하는 오류를 일찍 발견할 수 있습니다.
- 재화나 아이템 지급 AC에 서버 검증 조건이 있는가?
- 보상 수령과 같은 일회성 작업에 중복 요청 처리가 있는가?
- 네트워크 실패 시 클라이언트가 성공 상태로 고정되지 않는가?
- 시간 기반 기능에 타임존과 초기화 기준이 명시되어 있는가?
- 권한이 필요한 기능에 로그인·플랫폼 계정 조건이 있는가?
- 범위 밖인 튜토리얼, 분석 이벤트, 운영 도구가 몰래 포함되지 않았는가?
자동화의 효과를 어떻게 측정할까?
“AI를 도입했다”는 사실보다 문서 작성과 리뷰 흐름이 실제로 개선됐는지를 측정해야 합니다. 예를 들어 다음 지표를 스프린트 단위로 비교할 수 있습니다.
- 문서화 리드타임: 승인된 기획 명세서 시각과 Jira 유저 스토리 생성 시각의 차이
- 재작업률: 리뷰 후 핵심 요구사항이 변경된 이슈 수를 AI 생성 이슈 수로 나눈 값
- AC 결함률: QA 단계에서 AC 누락 또는 모호성이 발견된 이슈 수를 전체 대상 이슈 수로 나눈 값
- 생성 결과를 수정 없이 승인한 비율
- 개발 중 요구사항 재해석으로 발생한 재작업 수
수정 없이 승인한 비율이 높다고 항상 좋은 것은 아닙니다. 리뷰가 생략된 것인지 입력 템플릿과 출력 품질이 안정된 것인지 함께 확인해야 합니다.
자주 묻는 질문(FAQ)
Jira 유저 스토리만 전달해도 기획 명세서를 만들 수 있나요?
초안은 만들 수 있지만 최종 명세서로 사용하기에는 부족합니다. 관련 화면, 서버 처리, 기존 결정사항, 제외 범위를 함께 전달하고 정보가 없는 항목은 openQuestions로 남겨야 합니다.
AI가 만든 인수 조건을 그대로 테스트 케이스로 사용해도 되나요?
안 됩니다. AC는 테스트 설계의 출발점입니다. QA는 실제 빌드, 데이터 상태, 플랫폼 조건, 네트워크 환경을 기준으로 실행 가능한 테스트 케이스로 구체화해야 합니다.
모든 Jira 이슈에 자동 생성을 적용해야 하나요?
작은 Story와 반복적인 기능부터 시작하는 것이 좋습니다. 결제, 개인정보, 경제 시스템, 라이브 운영 정책처럼 위험도가 높은 영역은 AI 초안만 허용하고 승인 절차를 강화해야 합니다.
정리
Jira 백로그 유저 스토리의 AI 자동 생성은 문서를 대신 결정하는 기능이 아니라 팀이 빠르게 합의할 수 있도록 요구사항을 구조화하는 생산성 도구입니다. Jira Cloud REST API v3와 ADF 정규화로 입력을 통제하고 JSON Schema로 출력을 고정한 뒤 Given-When-Then AC, 미확정 질문, 서버 권위 규칙을 함께 검토하면 실무 활용도가 높아집니다.
가장 현실적인 도입 순서는 Story 10~20개로 시범 운영 → 리뷰 오류 분류 → 프롬프트·스키마 개선 → 승인된 결과만 Jira 반영입니다. 이 경계를 지켜야 일정과 스코프를 빠르게 정리하면서도 AI가 만든 추정을 팀의 확정 요구사항으로 오해하는 일을 줄일 수 있습니다.