Unity Compute Shader로 AI 타일맵 PCG 최적화하는 법: GPU 병렬 생성 파이프라인
Unity Compute Shader에서 AI가 만든 생물군계·난이도 조건을 타일맵 규칙으로 변환하고 GPU 병렬 연산으로 대형 맵 생성 병목을 줄이는 구현 방법을 단계별로 정리합니다.
핵심 요약
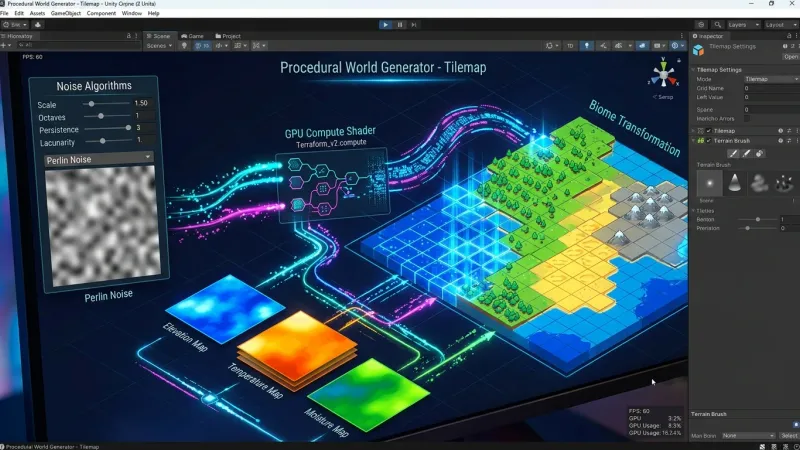
AI가 반환한 생물군계, 위험도, 관심 지점 같은 고수준 조건을 타일별 규칙으로 바꾸고 각 타일의 독립적인 판정은 Unity Compute Shader에서 병렬 처리하면 CPU 루프와 SetTile 호출 병목을 크게 줄일 수 있다. 핵심은 AI 추론을 GPU에서 재현하는 것이 아니라 AI의 결과를 작은 파라미터 버퍼로 전달하고 GPU가 노이즈·거리장·규칙 우선순위를 계산하도록 분리하는 것이다.
Compute Shader 기반 AI 타일맵 PCG란 무엇인가?
AI 타일맵 절차적 생성(PCG)은 언어 모델이나 별도 생성 모델이 사막 중심, 북쪽은 설산, 보스 지역은 높은 위험도처럼 맵의 의도를 만들고 게임 클라이언트가 이를 실제 타일 ID 배열로 변환하는 방식이다.
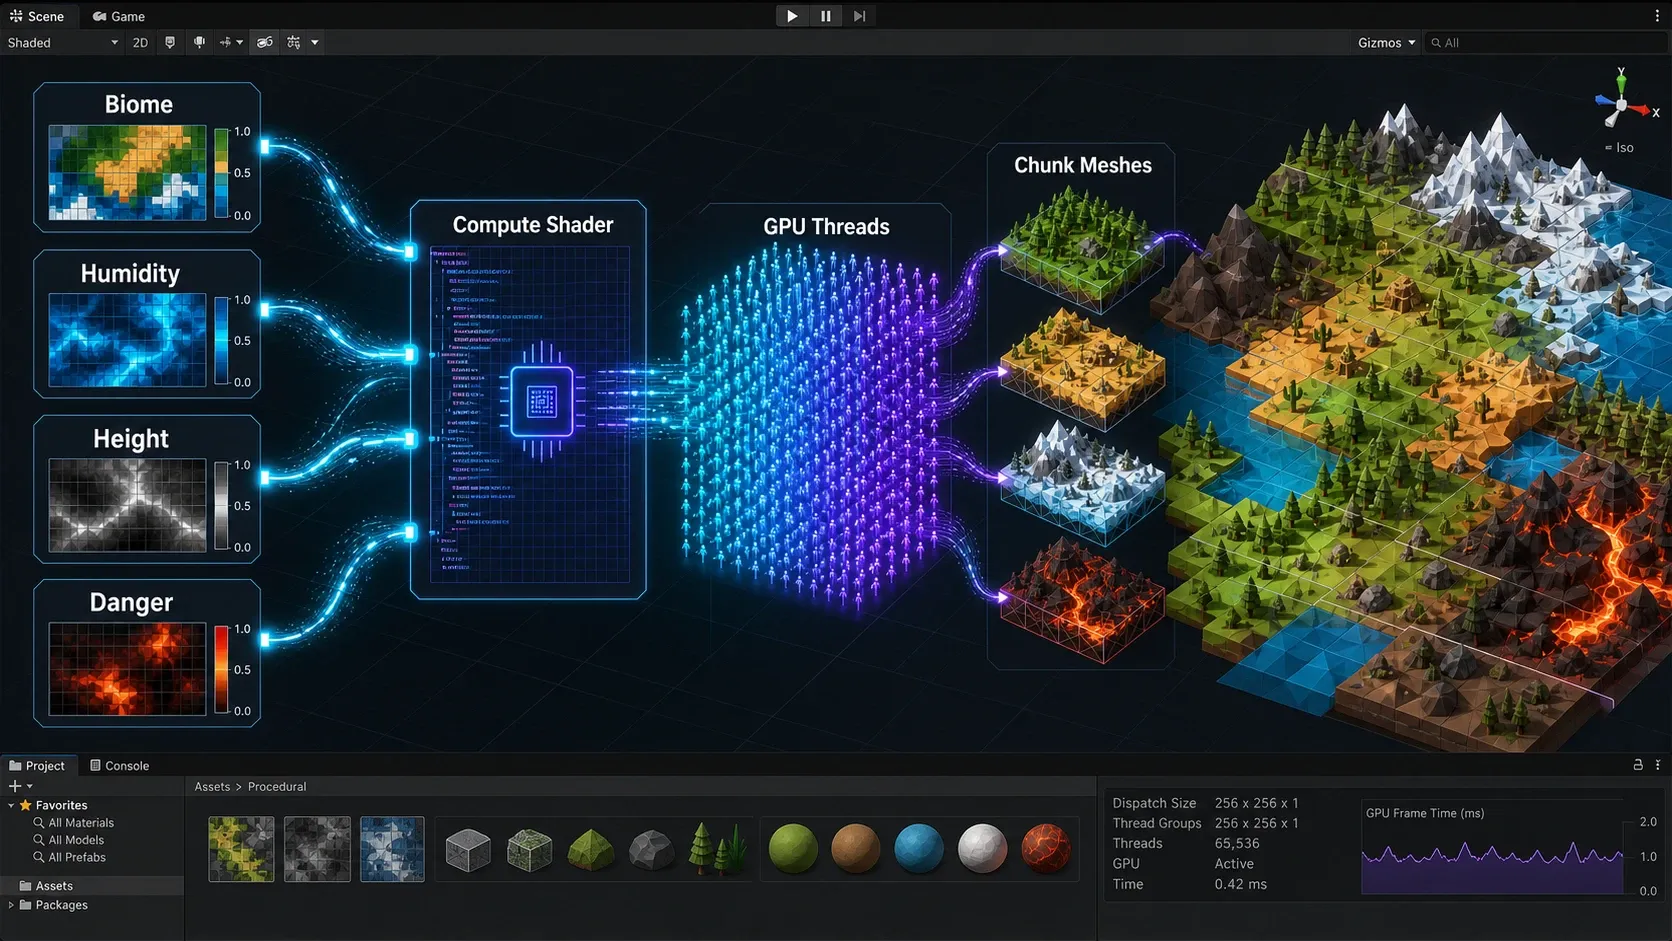
여기서 Compute Shader는 타일 하나당 하나의 GPU 스레드를 배정한다. 예를 들어 1024×1024 맵은 1,048,576개 타일의 높이, 습도, 위험도, 지형 타입을 병렬 계산할 수 있다. 단, 타일 간 의존성이 큰 경로 탐색이나 연결성 보정까지 한 커널에 넣으면 동기화와 메모리 접근 비용이 커질 수 있다.
| 역할 | 권장 실행 위치 | 이유 |
|---|---|---|
| 생물군계 서술, 월드 규칙 생성 | 서버 또는 CPU | 결과가 저빈도로 바뀌며 외부 AI 호출과 잘 맞는다 |
| 타일별 노이즈, 거리, 임계값 판정 | Compute Shader | 대량의 독립 연산을 병렬화할 수 있다 |
| 타일맵 렌더링 | GPU 인스턴싱 또는 청크 메시 | 타일 객체 생성과 개별 API 호출을 피할 수 있다 |
| 연결성 검사, 스폰 규칙 보정 | CPU 또는 별도 GPU 패스 | 전역 데이터와 반복 제어가 필요하다 |
CPU 타일맵 생성은 왜 느려지는가?
가장 흔한 병목은 노이즈 함수 자체보다 C# 반복문 안에서 발생하는 엔진 API 호출이다. 타일마다 Tilemap.SetTile을 호출하면 관리 코드와 네이티브 코드 사이를 반복 왕복하고 타일맵 내부 갱신도 자주 일어난다.
다음 식처럼 타일 수가 증가할수록 CPU 작업량은 선형으로 커진다.
타일 하나에 높이 노이즈, 습도 노이즈, 생물군계 거리 계산, 타일 배정이 포함되면 대략적인 CPU 비용은 다음과 같다.
C_api가 큰 구조라면 노이즈를 미세하게 최적화해도 체감 개선이 작다. 먼저 타일별 API 호출을 배치 처리나 청크 메시 갱신으로 바꾸는 편이 효과적이다.
AI 타일맵 조건을 GPU 파라미터로 어떻게 변환할까?
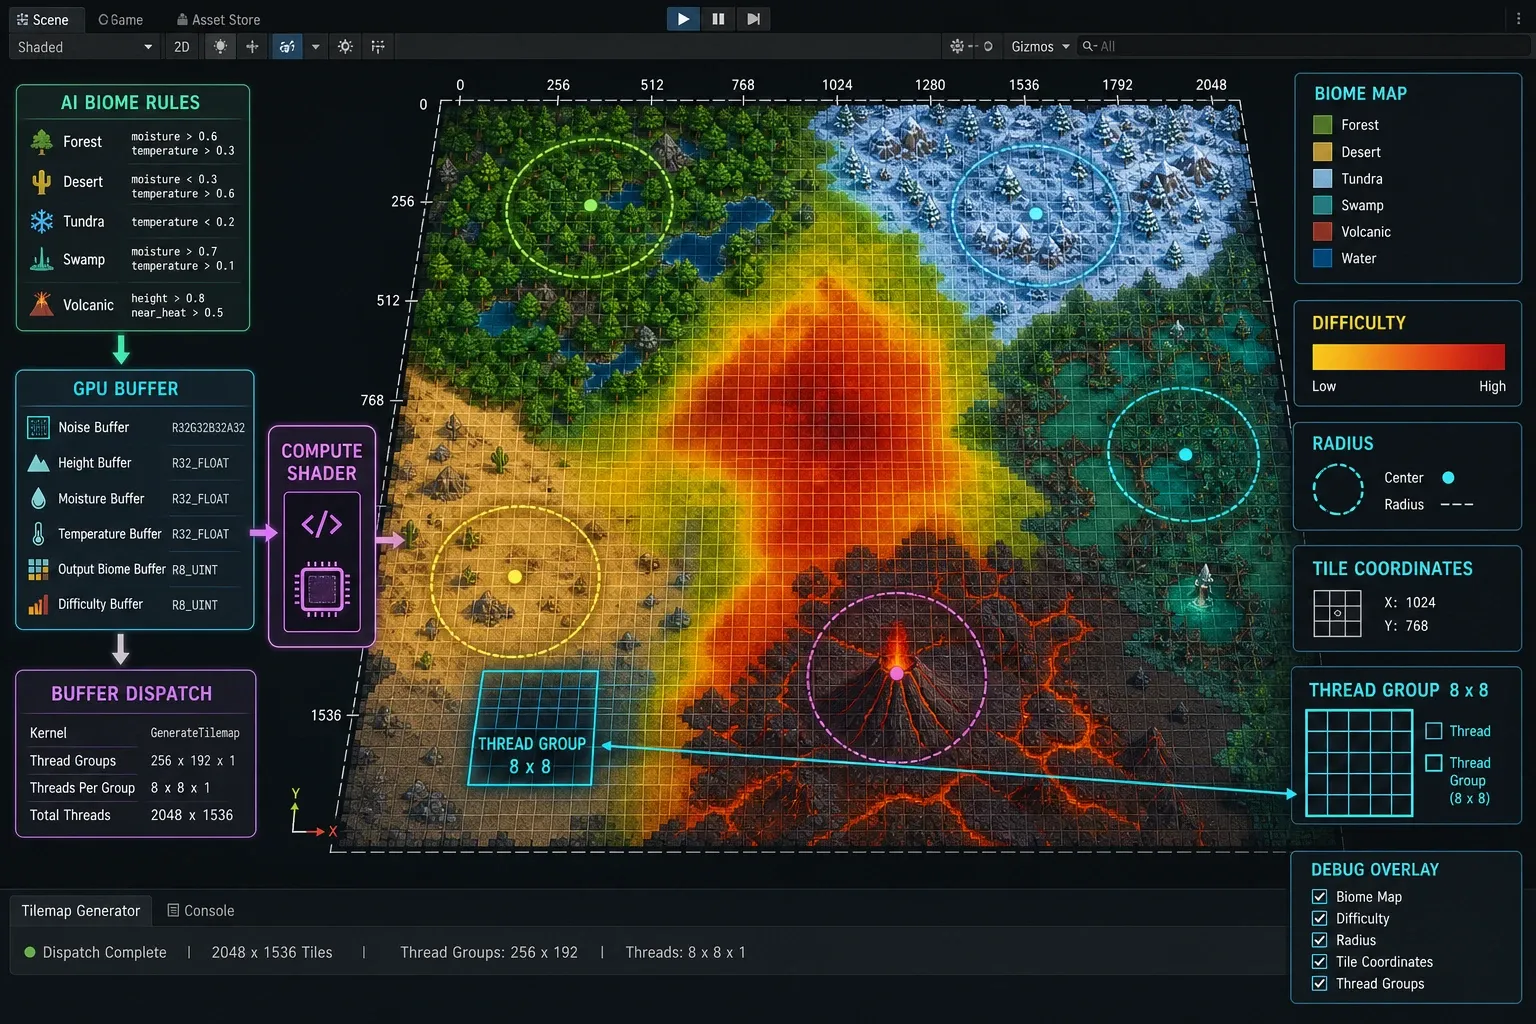
AI 출력은 자유 문장 그대로 쓰지 말고 검증 가능한 구조체로 정규화한다. 예를 들어 생물군계 중심 좌표, 반경, 타일 ID, 임계값만 클라이언트에 전달한다. 좌표 범위와 타일 ID를 검증하지 않으면 잘못된 입력이 GPU 버퍼 범위를 벗어나거나 의도하지 않은 맵을 만들 수 있다.
Step 1. AI 결과를 제한된 생성 명세로 정규화한다
[System.Serializable]
public struct BiomeRule
{
    public Vector4 centerRadiusMinHeight;
    public Vector4 tileData;
}
예를 들어 AI 응답은 BiomeRule 최대 16개로 제한한다. radius는 1 이상, tileId는 등록된 타일 팔레트 범위 안인지 검증한 뒤 GPU에 보낸다.
Step 2. 규칙과 전역 설정을 ComputeBuffer로 업로드한다
[SerializeField] ComputeShader tileGenerator;
[SerializeField] int mapSize = 1024;

ComputeBuffer ruleBuffer;
ComputeBuffer tileBuffer;

public void Generate(BiomeRule[] rules)
{
    ruleBuffer?.Release();
    tileBuffer?.Release();

    ruleBuffer = new ComputeBuffer(rules.Length, 32);
    tileBuffer = new ComputeBuffer(mapSize * mapSize, sizeof(uint));
    ruleBuffer.SetData(rules);

    int kernel = tileGenerator.FindKernel("GenerateTiles");
    tileGenerator.SetInt("_MapSize", mapSize);
    tileGenerator.SetInt("_RuleCount", rules.Length);
    tileGenerator.SetFloat("_Seed", 173.0f);
    tileGenerator.SetBuffer(kernel, "_Rules", ruleBuffer);
    tileGenerator.SetBuffer(kernel, "_Tiles", tileBuffer);

    tileGenerator.Dispatch(kernel, Mathf.CeilToInt(mapSize / 8f), Mathf.CeilToInt(mapSize / 8f), 1);
}

void OnDestroy()
{
    ruleBuffer?.Release();
    tileBuffer?.Release();
}BiomeRule의 stride는 Vector2 8바이트, float 4바이트, int 4바이트로 총 20바이트처럼 보일 수 있다. 하지만 HLSL 구조체 정렬을 고려해 C#과 셰이더 양쪽에 명시적 패딩을 두거나 실제 stride를 두 구현에서 동일하게 맞춰야 한다. 실무에서는 float4 중심 구조로 패킹하면 오류를 줄이기 쉽다.
Step 3. 타일별 독립 판정을 한 커널에서 수행한다
#pragma kernel GenerateTiles

struct BiomeRule
{
    float4 centerRadiusMinHeight;
    float4 tileData;
};

RWStructuredBuffer<uint> _Tiles;
StructuredBuffer<BiomeRule> _Rules;
int _MapSize;
int _RuleCount;
float _Seed;

float Hash21(float2 p)
{
    p = frac(p * float2(123.34, 456.21));
    p += dot(p, p + 45.32);
    return frac(p.x * p.y);
}

[numthreads(8, 8, 1)]
void GenerateTiles(uint3 id : SV_DispatchThreadID)
{
    if (id.x >= _MapSize || id.y >= _MapSize) return;

    float2 uv = (float2(id.xy) + 0.5) / _MapSize;
    float height = Hash21(uv * 128.0 + _Seed);
    uint tile = 0; // 기본 평원

    for (int i = 0; i < _RuleCount; i++)
    {
        BiomeRule rule = _Rules[i];
        float distanceToCenter = distance(uv, rule.centerRadiusMinHeight.xy);

        if (distanceToCenter <= rule.centerRadiusMinHeight.z
            && height >= rule.centerRadiusMinHeight.w)
            tile = (uint)rule.tileData.x;
    }

    _Tiles[id.y * _MapSize + id.x] = tile;
}
Compute Shader 타일맵 PCG를 어떻게 최적화할까?
1. 스레드 그룹 크기를 타깃 GPU에 맞춘다
[numthreads(8, 8, 1)]은 64스레드 그룹으로 시작하기 좋은 값이다. 16×16은 그룹당 256스레드이므로 연산량과 레지스터 사용량에 따라 오히려 점유율이 떨어질 수 있다. RenderDoc, Unity Profiler, Frame Debugger로 실제 타깃 기기에서 비교해야 한다.
| 상황 | 우선 선택 | 이유 |
|---|---|---|
| 모바일과 저사양 GPU | 8×8 | 그룹 크기와 레지스터 압박이 비교적 작다 |
| 데스크톱에서 단순 타일 판정 | 8×8 또는 16×16 측정 | 메모리 접근과 점유율을 실제로 비교해야 한다 |
| 맵 경계가 청크 단위 | 청크 크기의 약수 | Dispatch와 경계 검사 낭비를 줄인다 |
2. GPU 결과를 매 프레임 CPU로 읽지 않는다
ComputeBuffer.GetData는 GPU와 CPU 사이 동기화를 유발할 수 있다. 생성 직후 매 프레임 읽는 구조는 Compute Shader의 이점을 상쇄한다.
가능하면 _Tiles 버퍼를 후속 렌더링 셰이더 또는 간접 인스턴싱 단계에서 바로 사용한다. CPU가 결과를 반드시 받아야 한다면 월드 생성 완료 시점에 한 번만 읽거나 AsyncGPUReadback.Request로 비동기 수신한다.
3. 전체 맵 대신 더티 청크만 Dispatch한다
플레이어 행동으로 바뀐 청크만 다시 계산한다. 예를 들어 청크 크기가 64×64라면 1024×1024 전체 맵 대신 해당 청크의 4096개 타일만 갱신한다.
const int ChunkSize = 64;
int groups = ChunkSize / 8;
tileGenerator.Dispatch(kernel, groups, groups, 1);
청크 경계의 노이즈가 달라지지 않도록 월드 좌표를 해시에 넣어야 한다. 청크 내부 로컬 좌표만 사용하면 인접 청크가 이어지지 않는다.
4. 규칙 우선순위와 루프 횟수를 제한한다
타일마다 모든 규칙을 순회하면 비용은 다음처럼 늘어난다.
여기서 R은 생물군계 규칙 수다. AI가 만든 규칙은 8~16개 수준으로 제한하고 우선순위가 높은 규칙부터 처리한다. 더 많은 규칙이 필요하다면 청크별 후보 규칙만 별도 버퍼에 넣어 전체 순회를 줄인다.
타일 결과를 Unity Tilemap에 바로 적용해야 할까?
작은 편집기용 맵이나 드문 생성에는 가능하다. 다만 런타임 대형 맵에서는 GPU가 계산한 결과를 다시 CPU 배열로 복사한 뒤 타일 하나씩 SetTile하는 설계가 병목이 되기 쉽다.
| 출력 방식 | 적합한 경우 | 주의점 |
|---|---|---|
Tilemap.SetTilesBlock | 작은 맵, 에디터 도구, 생성 빈도가 낮은 경우 | 개별 SetTile보다 낫지만 CPU 복사는 남는다 |
| 청크 메시 | 대형 2D 월드, 고정된 타일 스타일 | 콜라이더와 타일 메타데이터를 별도로 관리한다 |
| GPU 인스턴싱 | 반복 타일, 장식 오브젝트가 많은 경우 | 타일 아틀라스와 인스턴스 데이터 설계가 필요하다 |
| 셰이더 기반 타일 렌더링 | 시각용 지형 레이어 | 충돌, 네비게이션 데이터는 별도로 생성해야 한다 |
게임플레이 충돌과 길찾기가 필요하다면 시각 타일과 논리 그리드를 분리하는 것이 안전하다. GPU는 시각적 지형과 대량 후보 생성에 쓰고 충돌 가능한 타일만 CPU 또는 비동기 읽기로 논리 청크에 반영한다.
자주 묻는 질문 (FAQ)
Compute Shader가 항상 CPU 타일맵 생성보다 빠른가?
아니다. 32×32처럼 작은 맵을 한 번 만들거나 CPU 결과가 즉시 필요한 경우에는 버퍼 업로드와 읽기 비용이 더 클 수 있다. 대형 맵, 다수 청크, 반복적인 독립 타일 계산에서 효과가 크다.
AI 모델을 Compute Shader에서 직접 실행할 수 있는가?
일반적인 Unity Compute Shader만으로는 적합하지 않다. AI 모델 추론은 Sentis 같은 런타임 또는 서버에서 수행하고 그 결과를 생물군계 파라미터와 규칙으로 압축해 전달하는 편이 단순하고 검증하기 쉽다.
타일 간 연결성은 GPU에서 처리해야 하는가?
반드시 그렇지 않다. 먼저 GPU에서 지형 후보를 생성하고 시작점과 목표점 연결성처럼 전역 판단이 필요한 부분만 CPU에서 보정하는 하이브리드 구조가 구현과 디버깅 비용 면에서 유리하다.
정리
Compute Shader 기반 AI 타일맵 PCG의 목표는 AI가 만든 월드 의도를 GPU가 대량 타일 데이터로 빠르게 펼치도록 만드는 것이다. 타일별 판정은 GPU로 옮기고 CPU 읽기와 개별 Tilemap API 호출은 최소화하며 재생성 범위는 더티 청크로 제한하자. 먼저 프로파일러에서 CPU API 호출과 GPU readback 비용을 확인한 뒤 실제 병목이 있는 경로만 교체하는 것이 가장 안전한 최적화다.